MLOps auf AWS: ein Modell zur Produktklassifizierung trainieren und ausliefern
Ein großer Onlinehändler, ein Katalog mit Millionen Produkten und ein Modell, das rohe Produktdaten in einheitliche, strukturierte Informationen verwandelt.
Einheitlich klassifizierte Produkte sind in Suche und Navigation leichter zu finden.
Produkte, die häufiger gefunden werden, verkaufen sich häufiger.
Die Geschichte
In einem Katalog mit Millionen Produkten kommen Produktdaten unvollständig und uneinheitlich an. Von Hand zu klassifizieren skaliert nicht, das Ziel war also ein trainiertes Modell, das es automatisch tut, auf Basis unterschiedlicher Arten von Produktdaten.
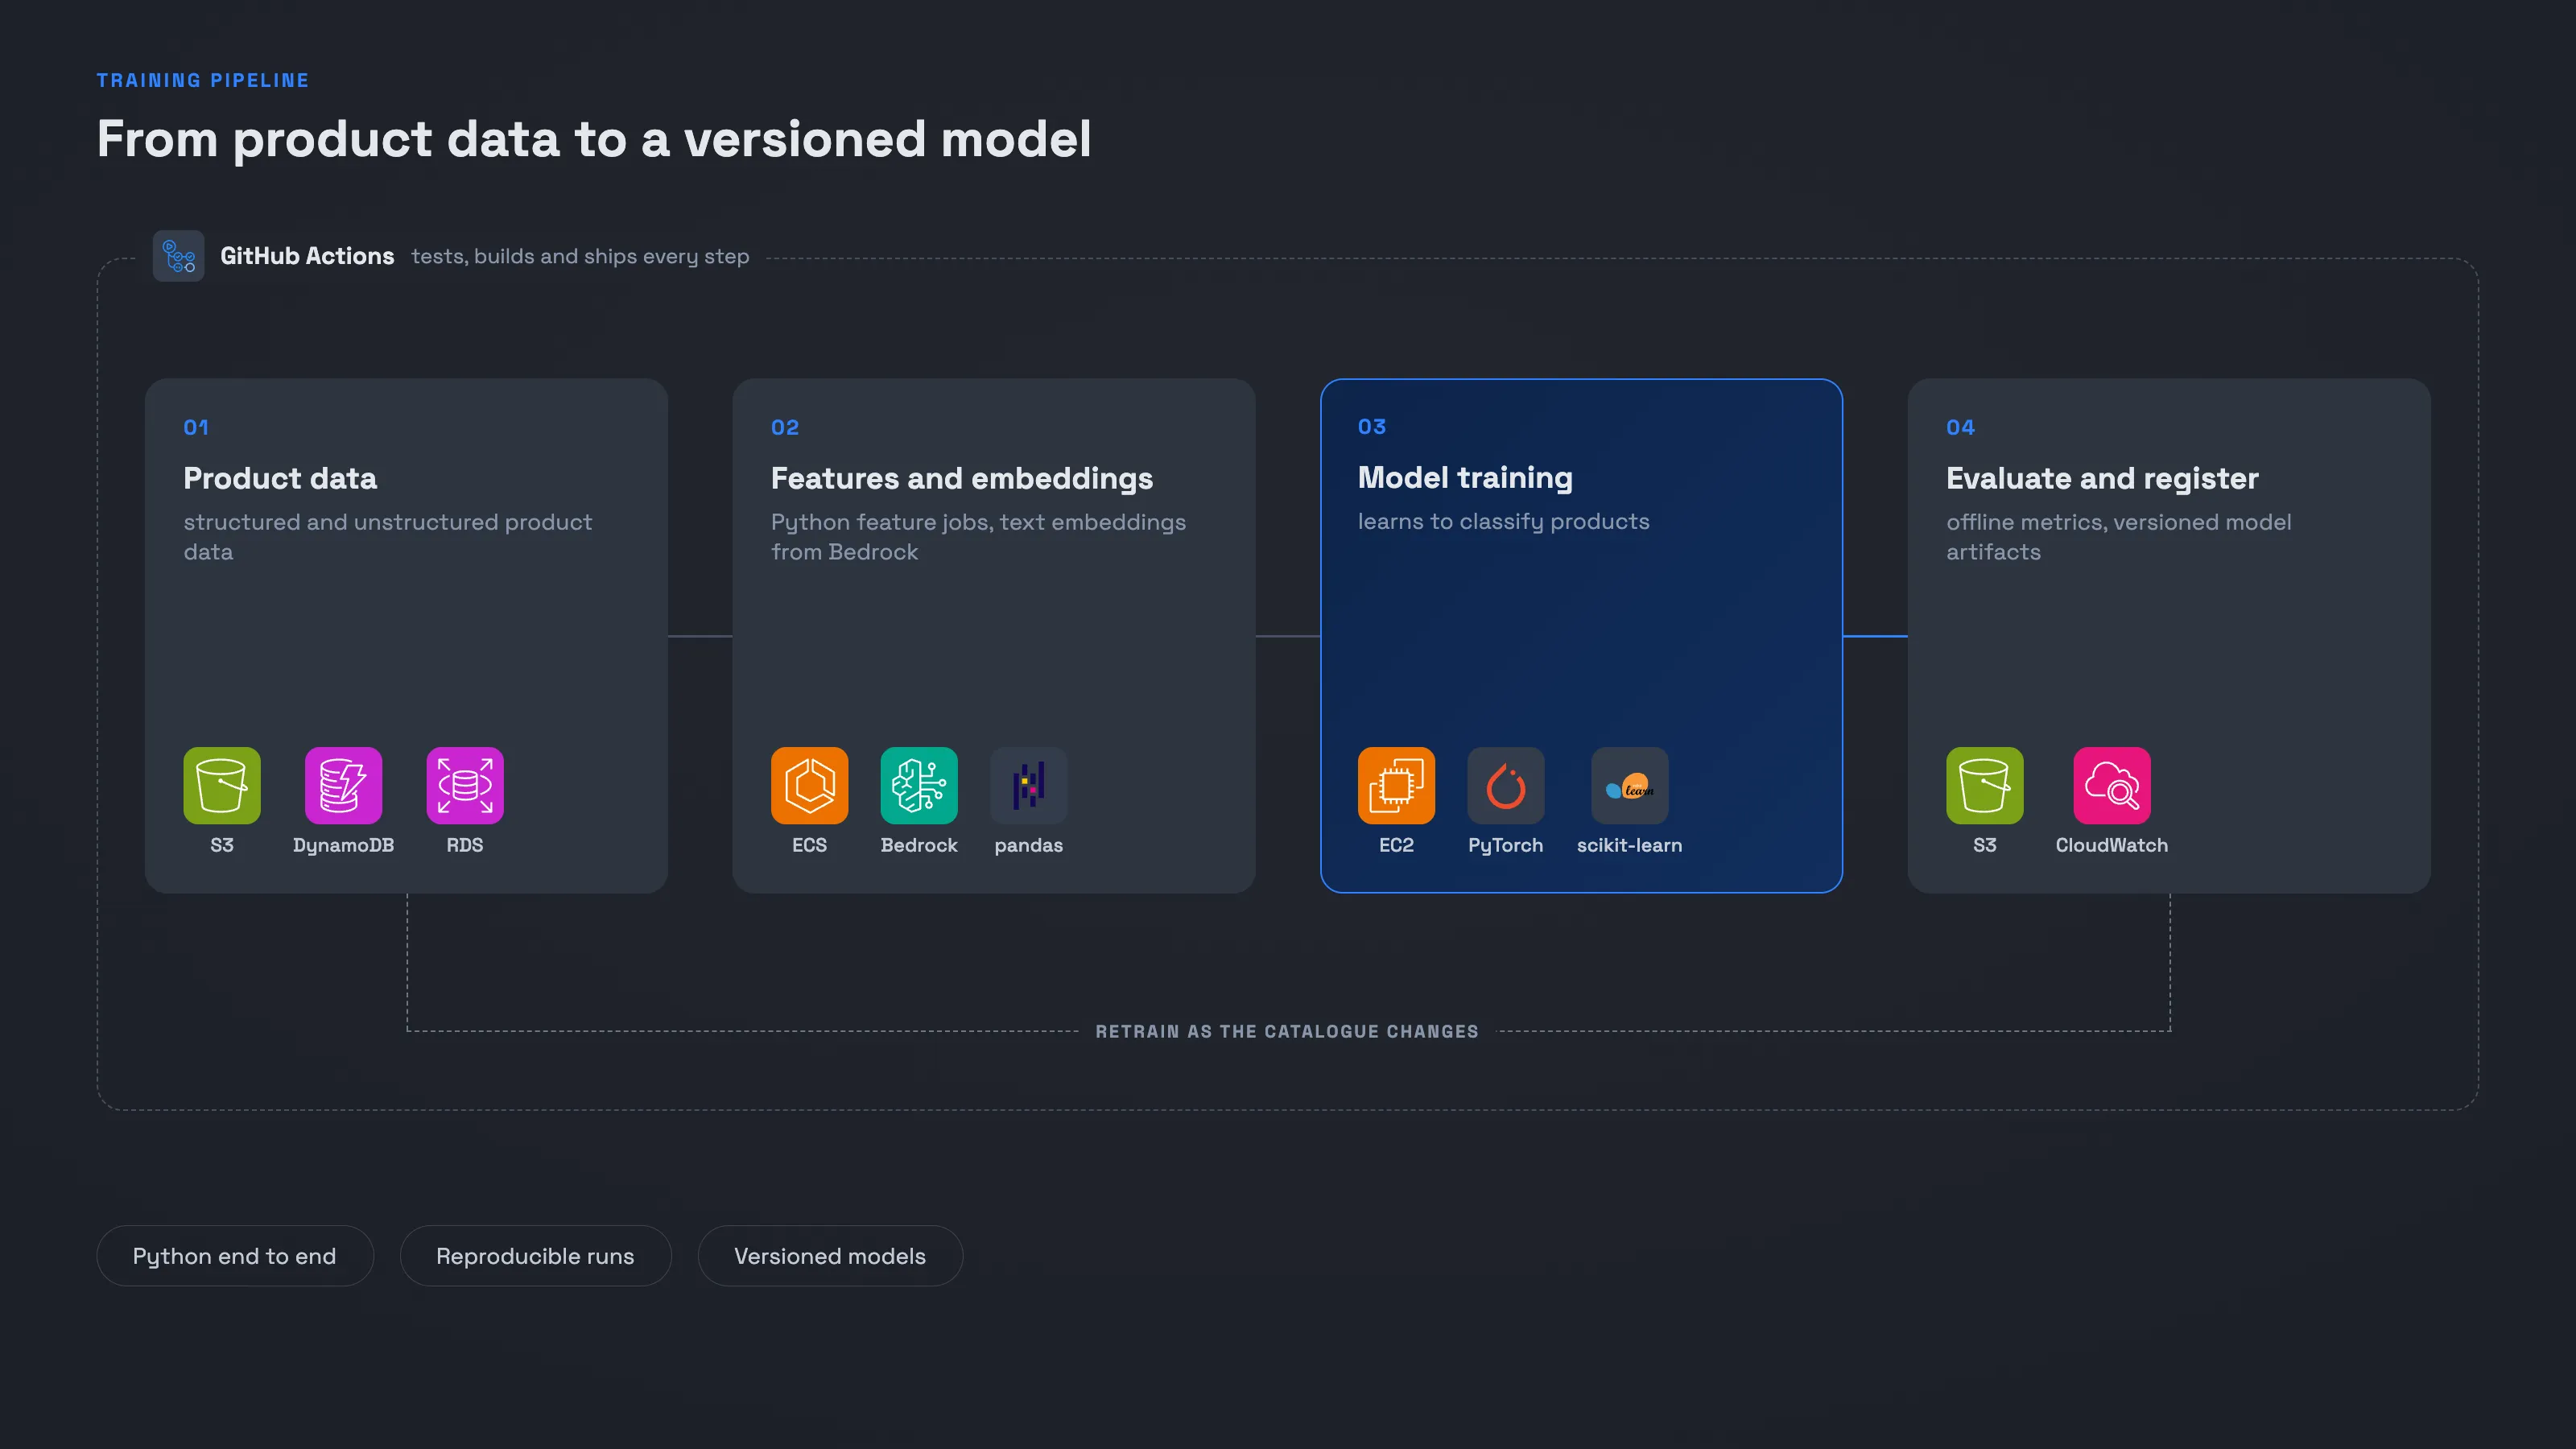
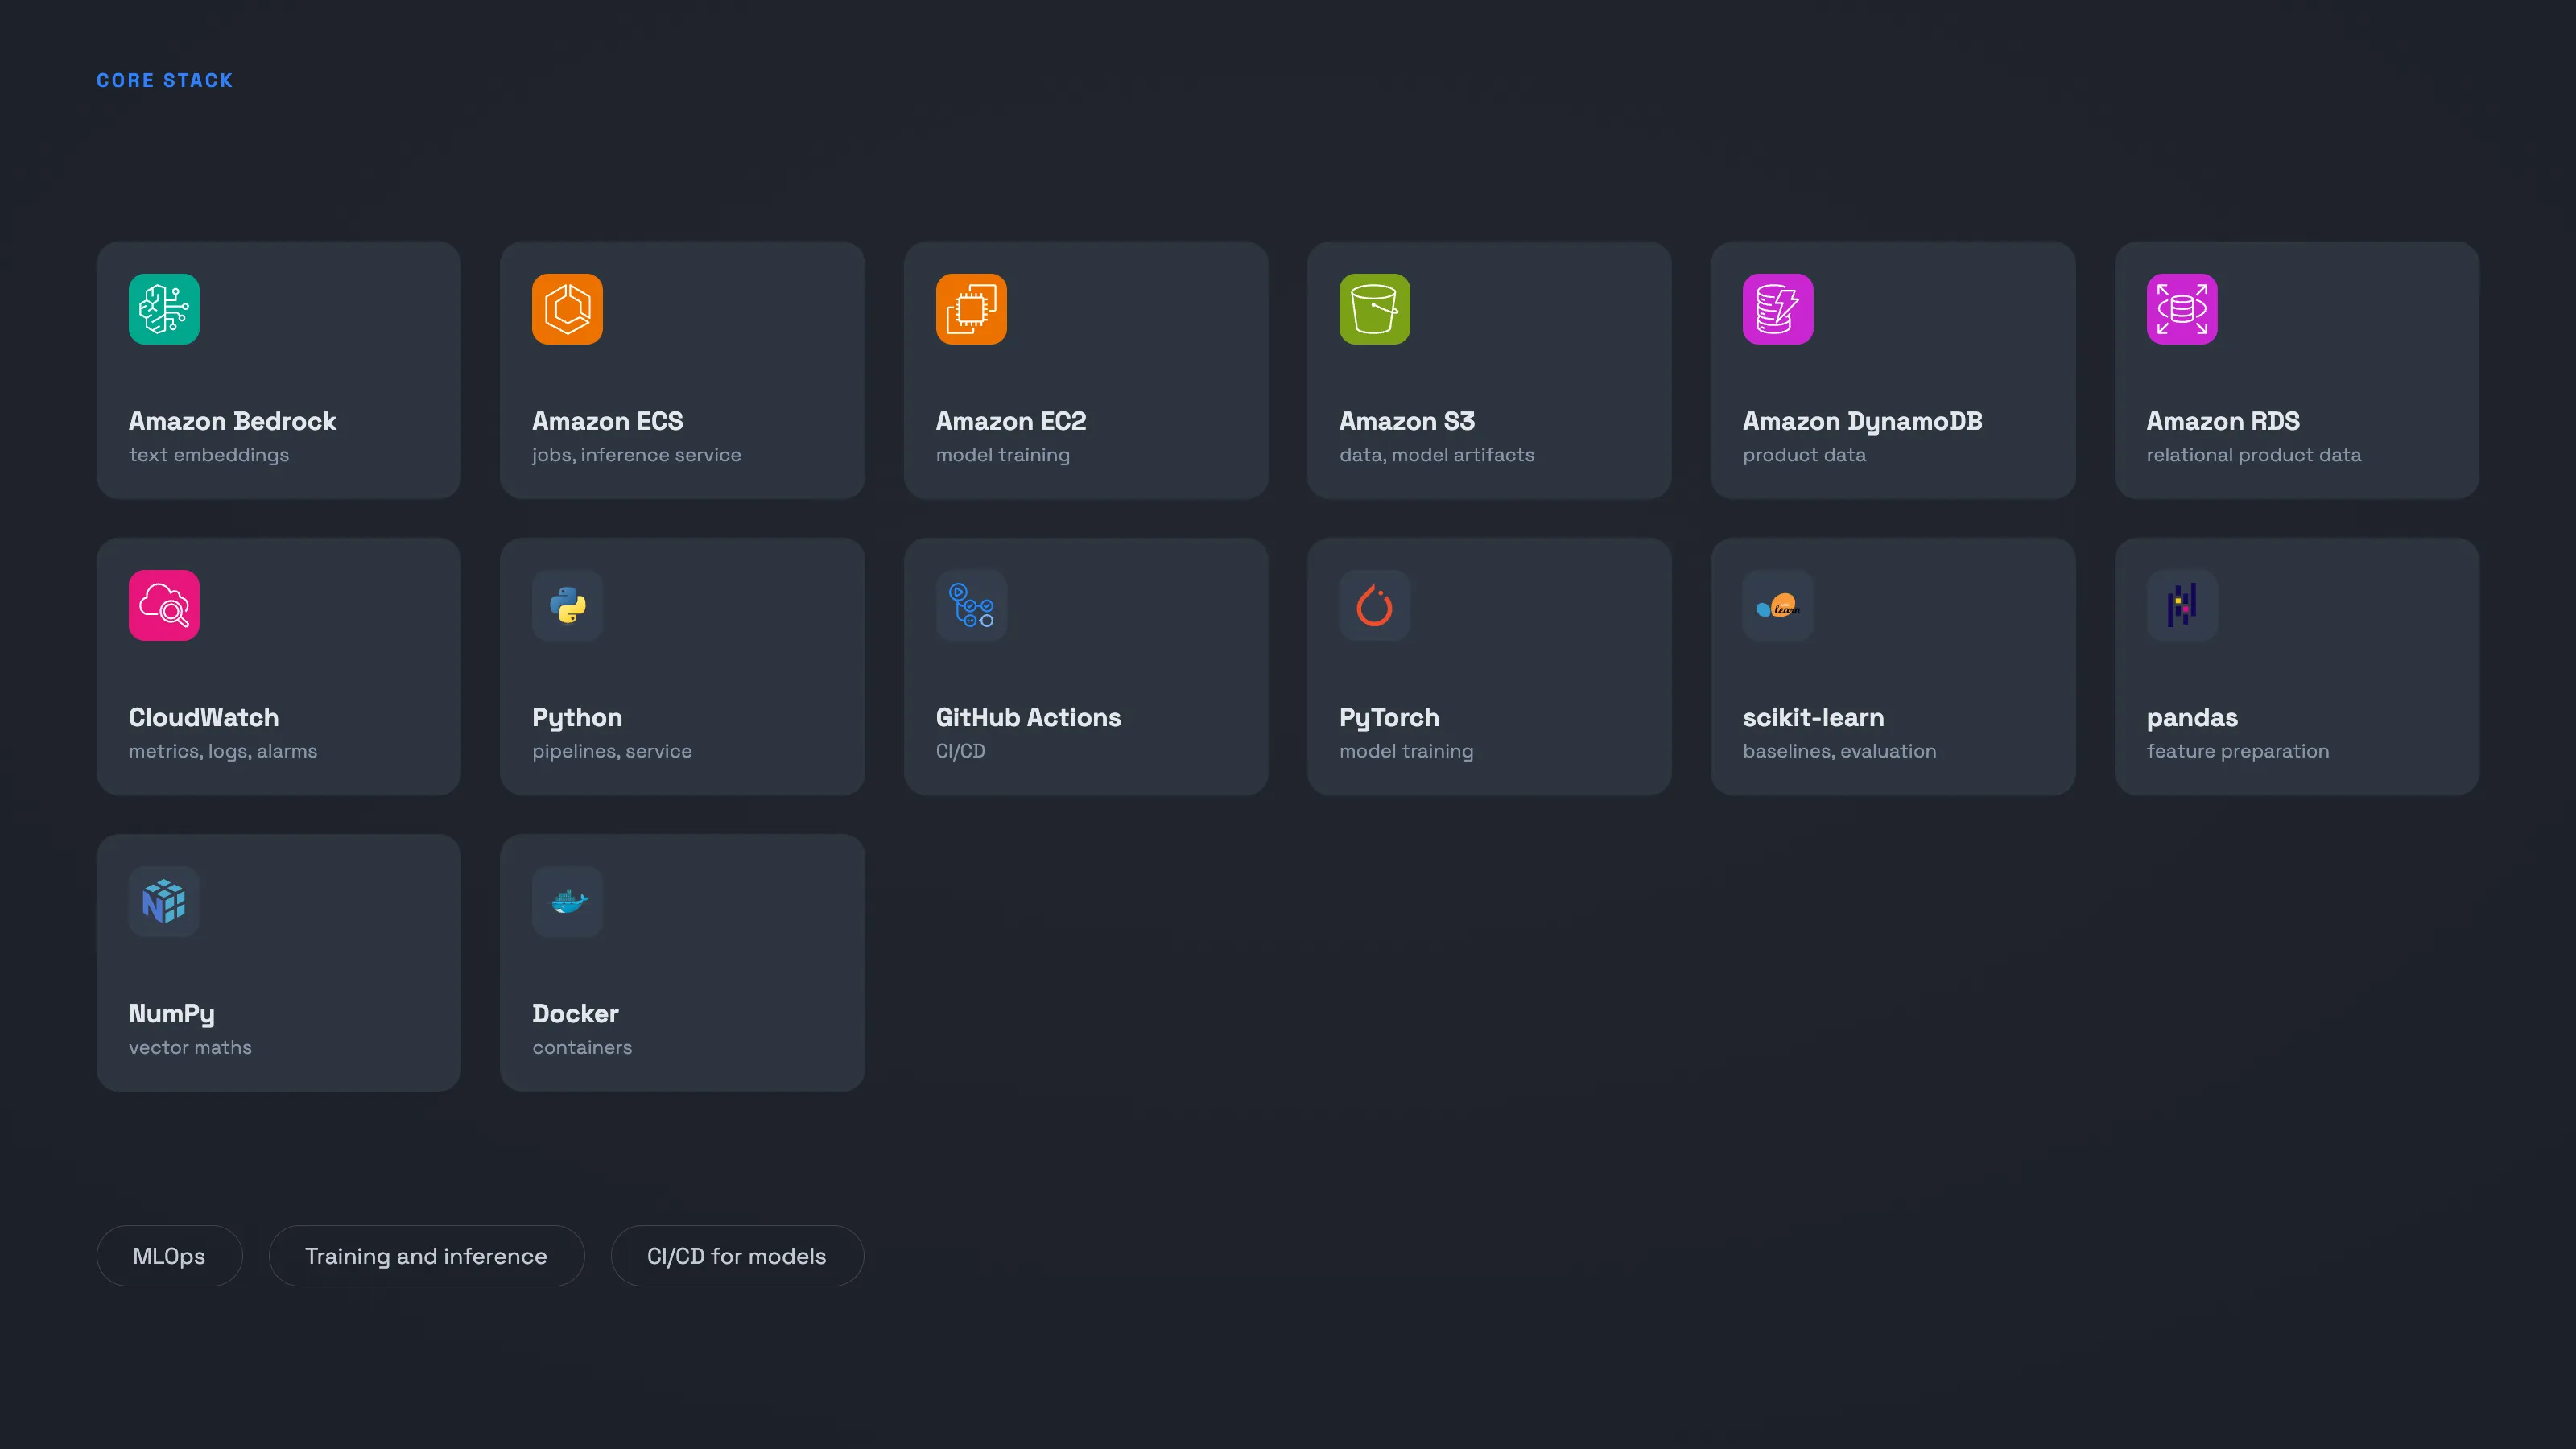
Ich habe die Trainingspipeline gebaut. Python-Jobs lesen Produktdaten aus DynamoDB und RDS, bereiten Features auf, erzeugen Text-Embeddings mit Amazon Bedrock und trainieren das Modell. Daten und versionierte Modellartefakte liegen in S3.
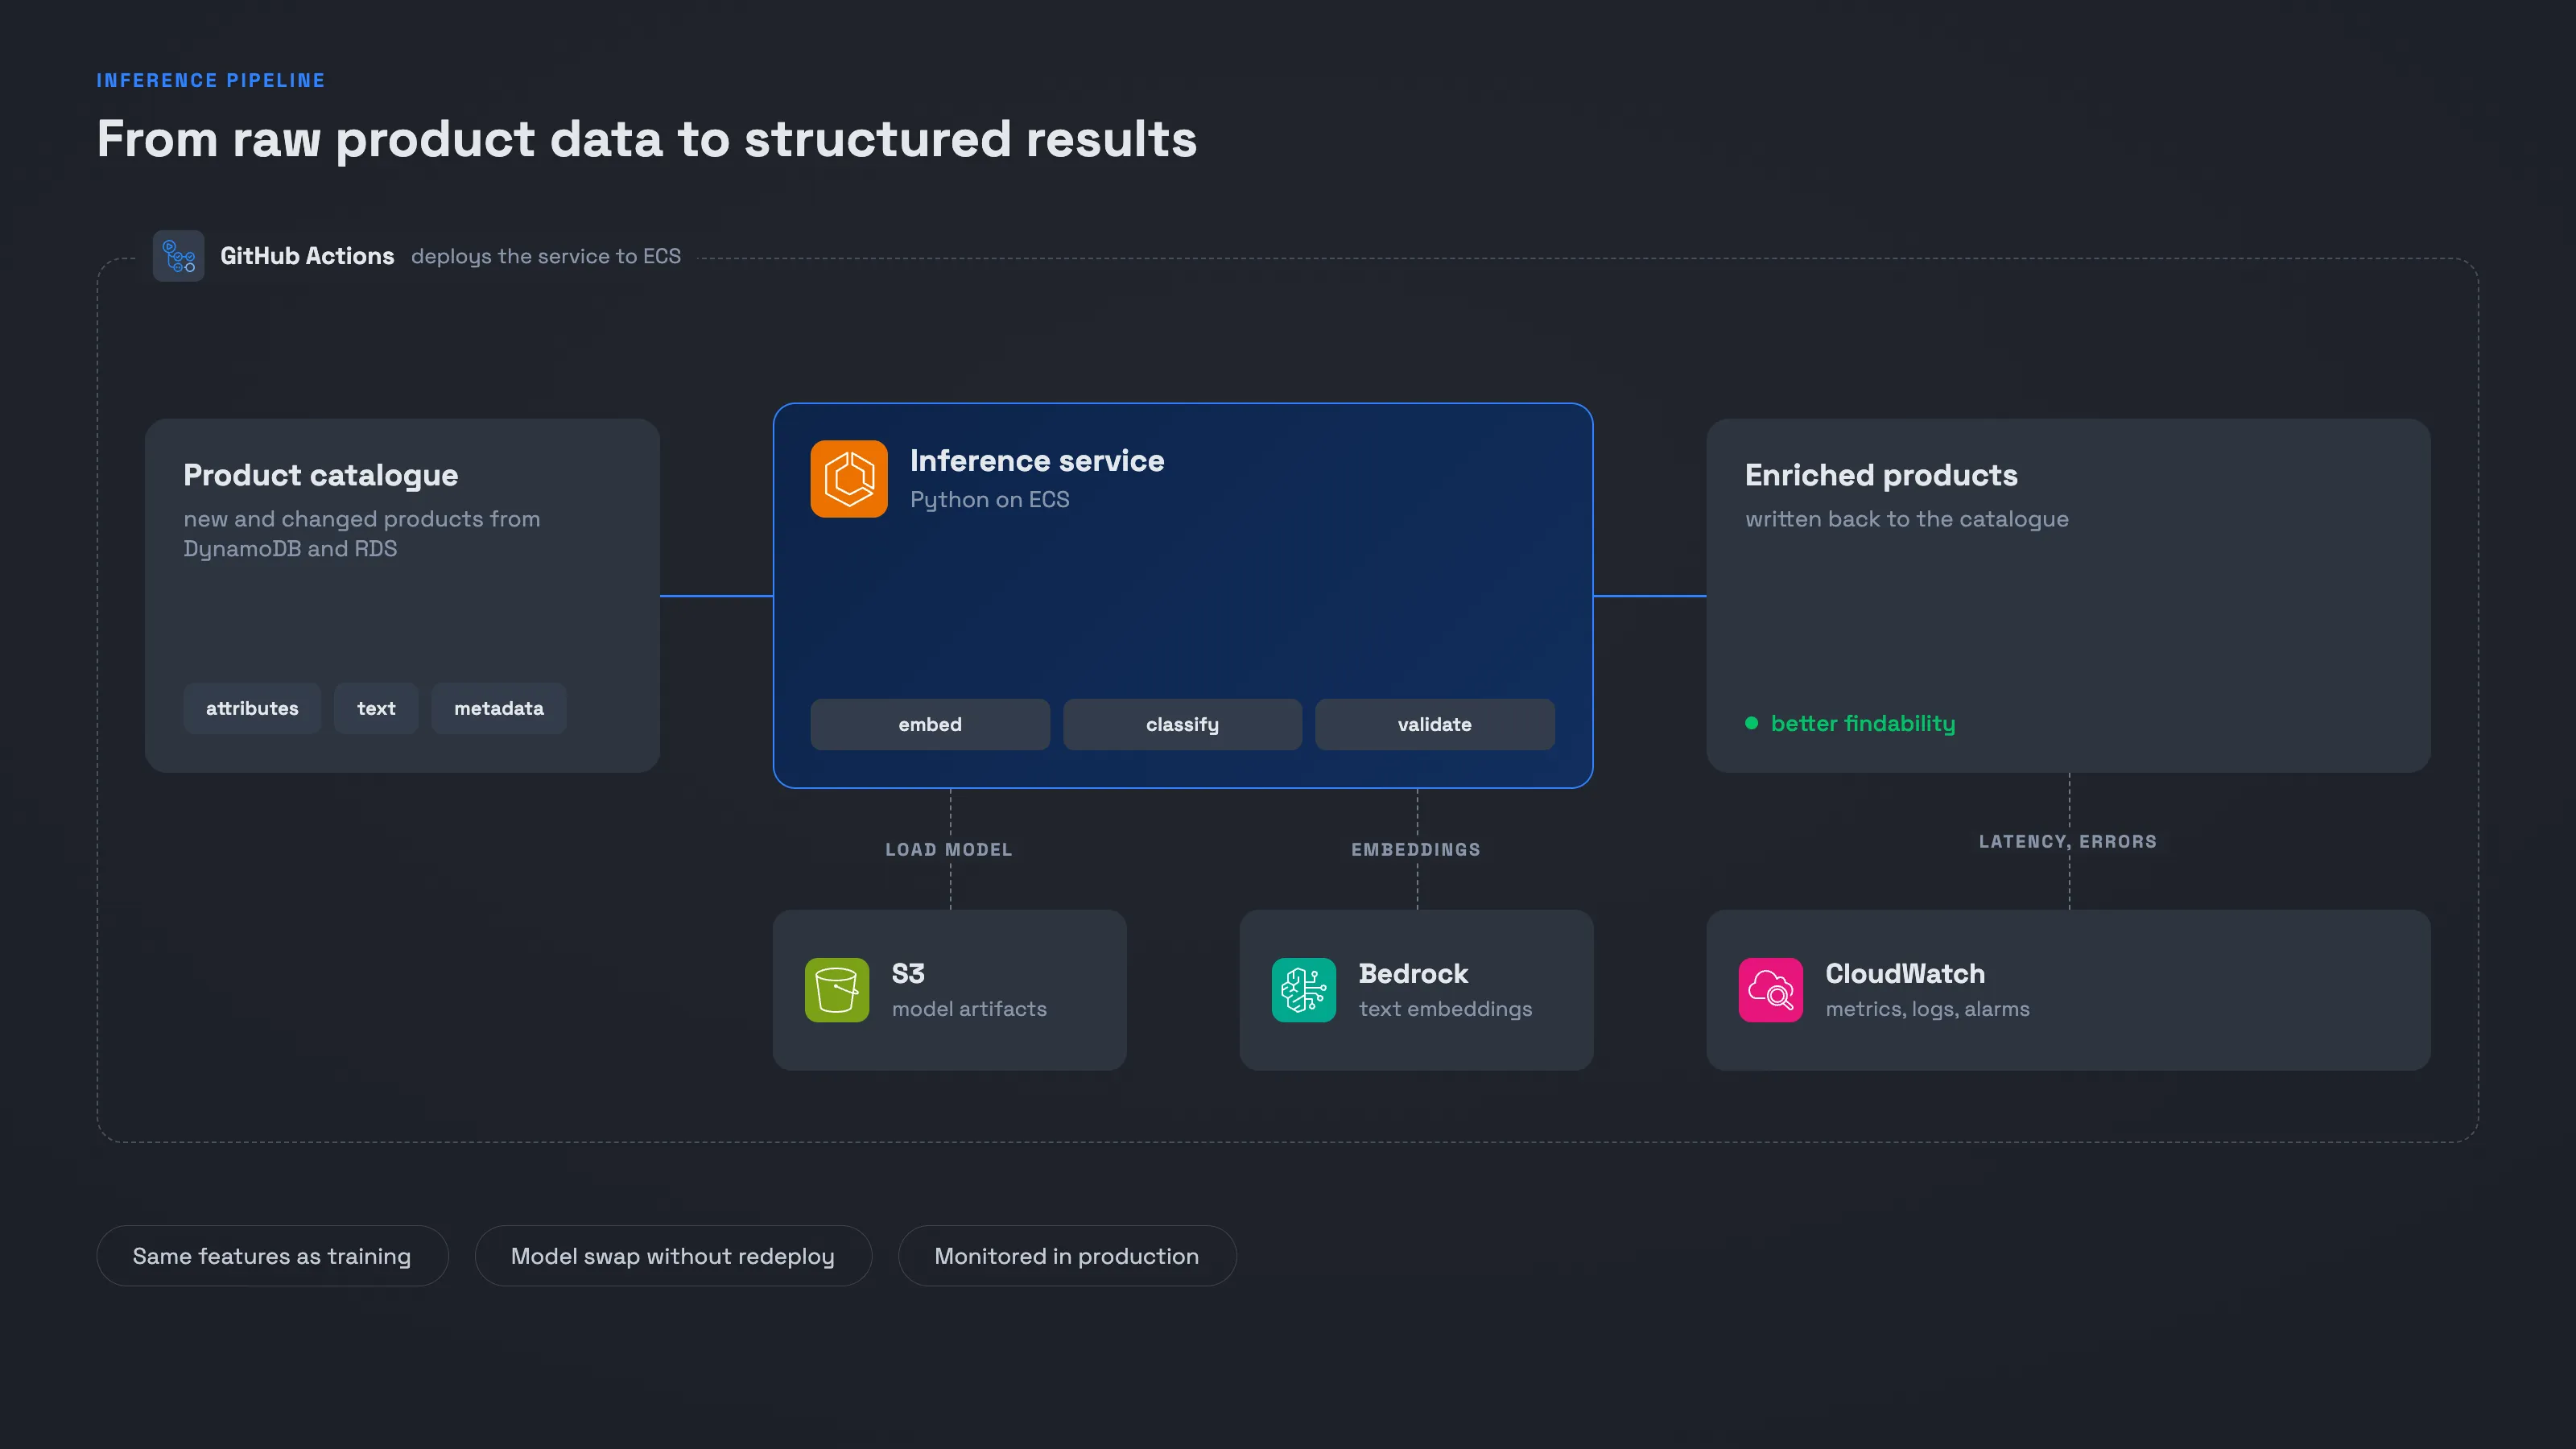
Ich habe auch die Inferenzpipeline gebaut, einen Python-Service auf ECS, der neue und geänderte Produkte klassifiziert und die Ergebnisse zurück in den Katalog schreibt. Überwacht wird er in CloudWatch, ausgeliefert über GitHub CI/CD.
Technologie


Andere interessante Case Studies
Steht bei Ihnen etwas Ähnliches an?
Erzählen Sie mir, was Sie heute betreiben und wo es hakt. Ich melde mich mit einem Vorschlag, wie ich es bauen würde und was ich so lassen würde.
Projekt besprechen