Wo der KV-Cache liegt: Storage-Tiering für LLM-Inferenz unter realem Traffic
Beim LLM-Serving geht der GPU-Speicher lange vor der Rechenleistung aus. Mit echten Konversations- und Produktions-Traces habe ich gemessen, was jede Storage-Ebene unterhalb der GPU einen laufenden Request kostet, und einen geteilten Cache-Tier auf GekkoFS gebaut, über den mehrere vLLM-Instanzen die Arbeit der jeweils anderen wiederverwenden.
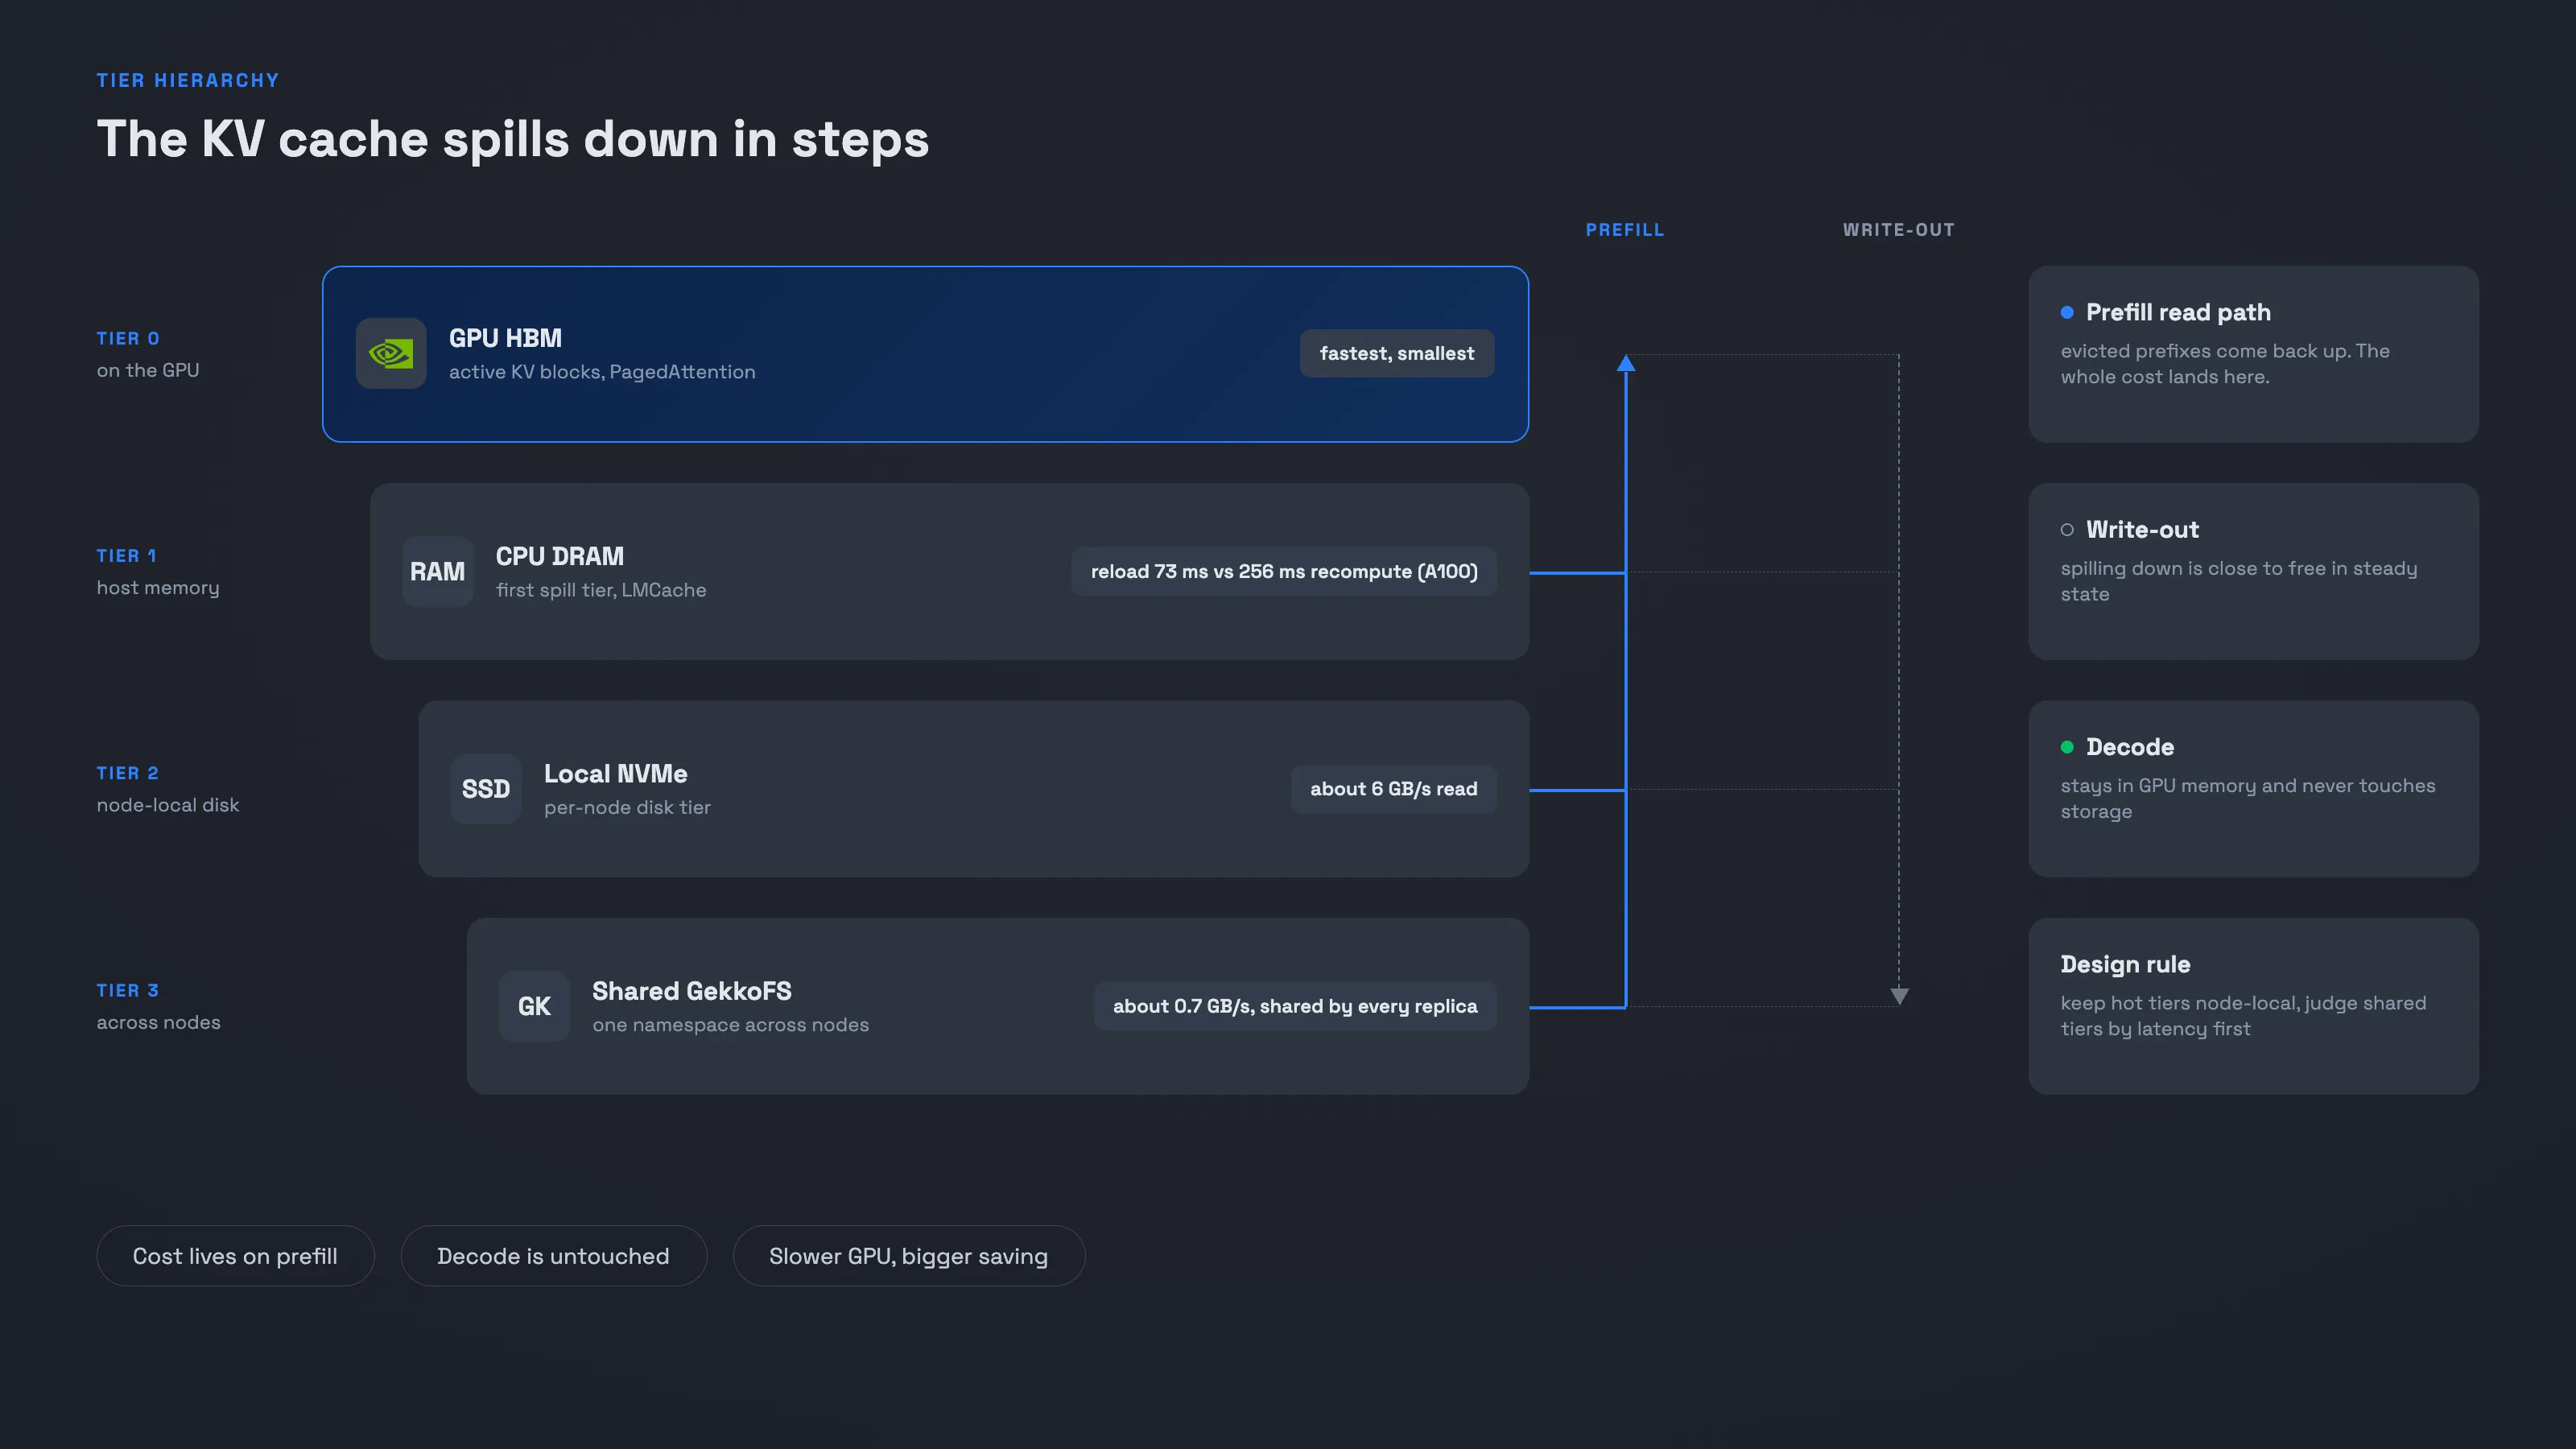
Einen verdrängten Prefix aus dem CPU-Speicher zurückzulesen dauerte auf einer A100 73 ms, ihn neu zu berechnen 256 ms. Je langsamer die GPU, desto größer die Ersparnis, und damit lohnt sich Cache-Tiering gerade auf kostengünstiger Hardware.
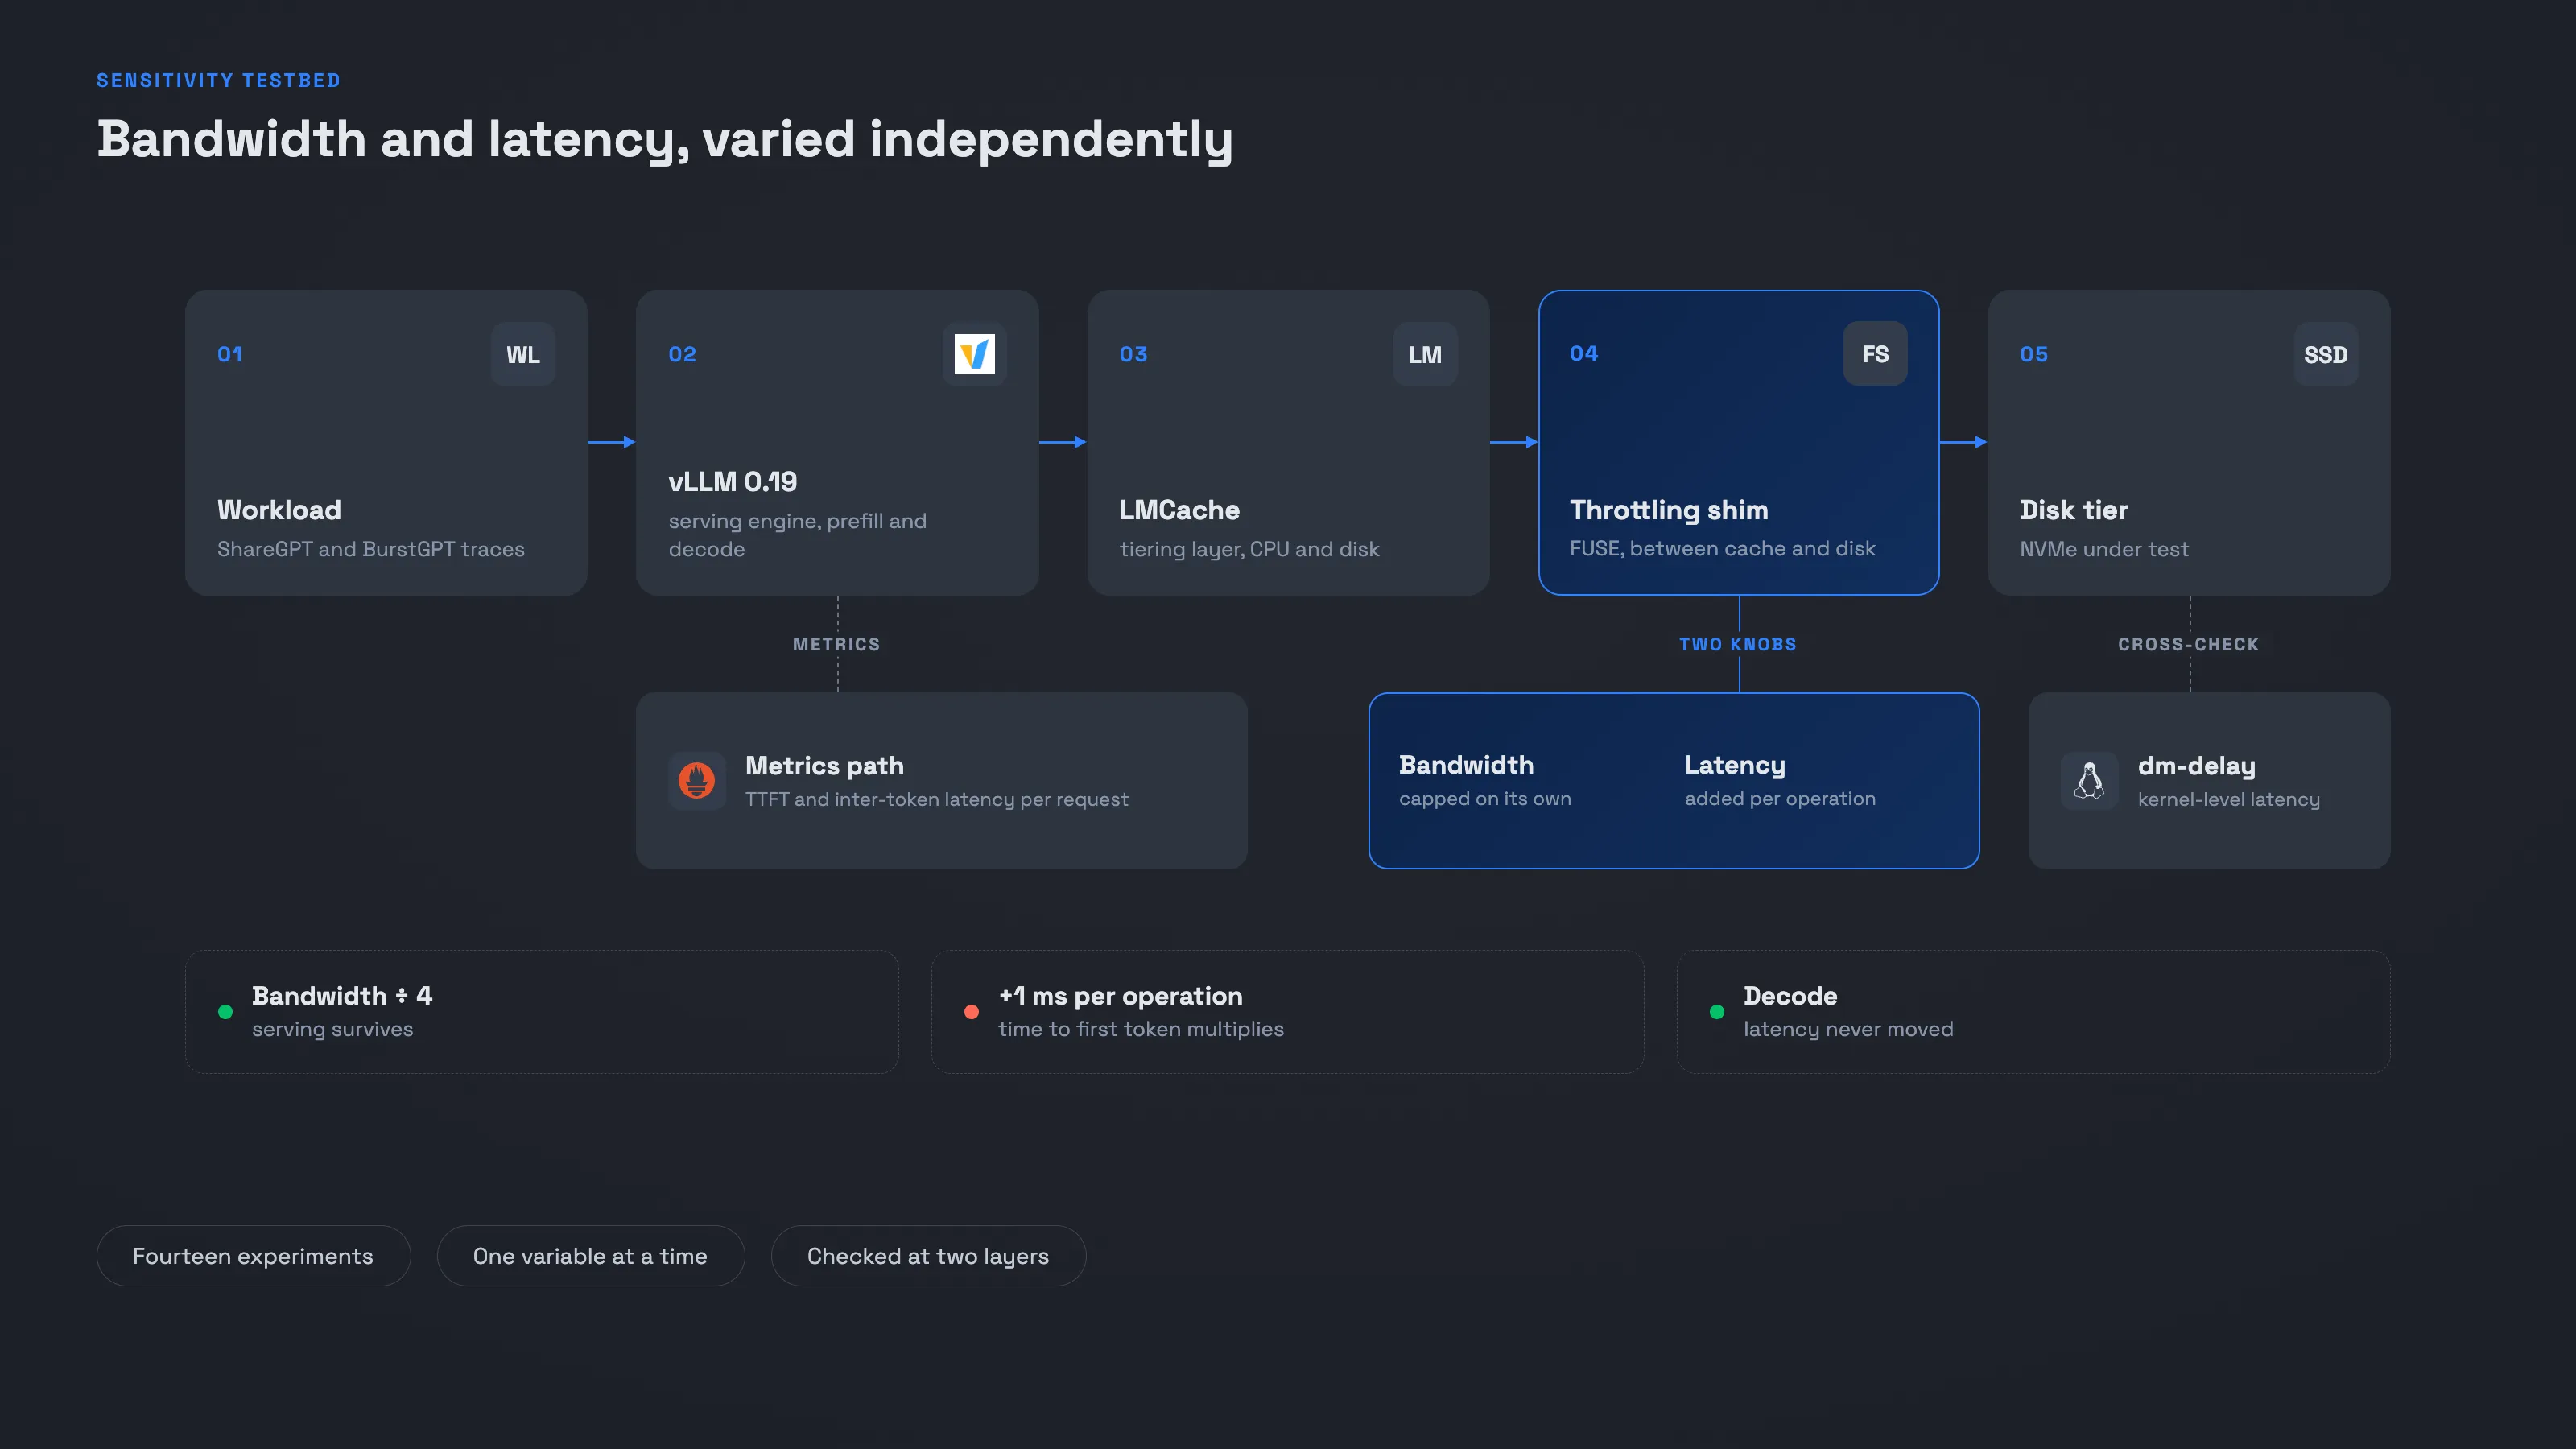
Kontrollierte Messreihen haben zwei Eigenschaften getrennt, die früherer Arbeiten immer gemeinsam verändern. Das Serving hat eine Kürzung auf ein Viertel der Plattenbandbreite überstanden, aber eine Millisekunde zusätzliche Latenz pro Operation hat die Zeit bis zum ersten Token um ein Vielfaches erhöht. Die Decode-Latenz blieb unverändert.
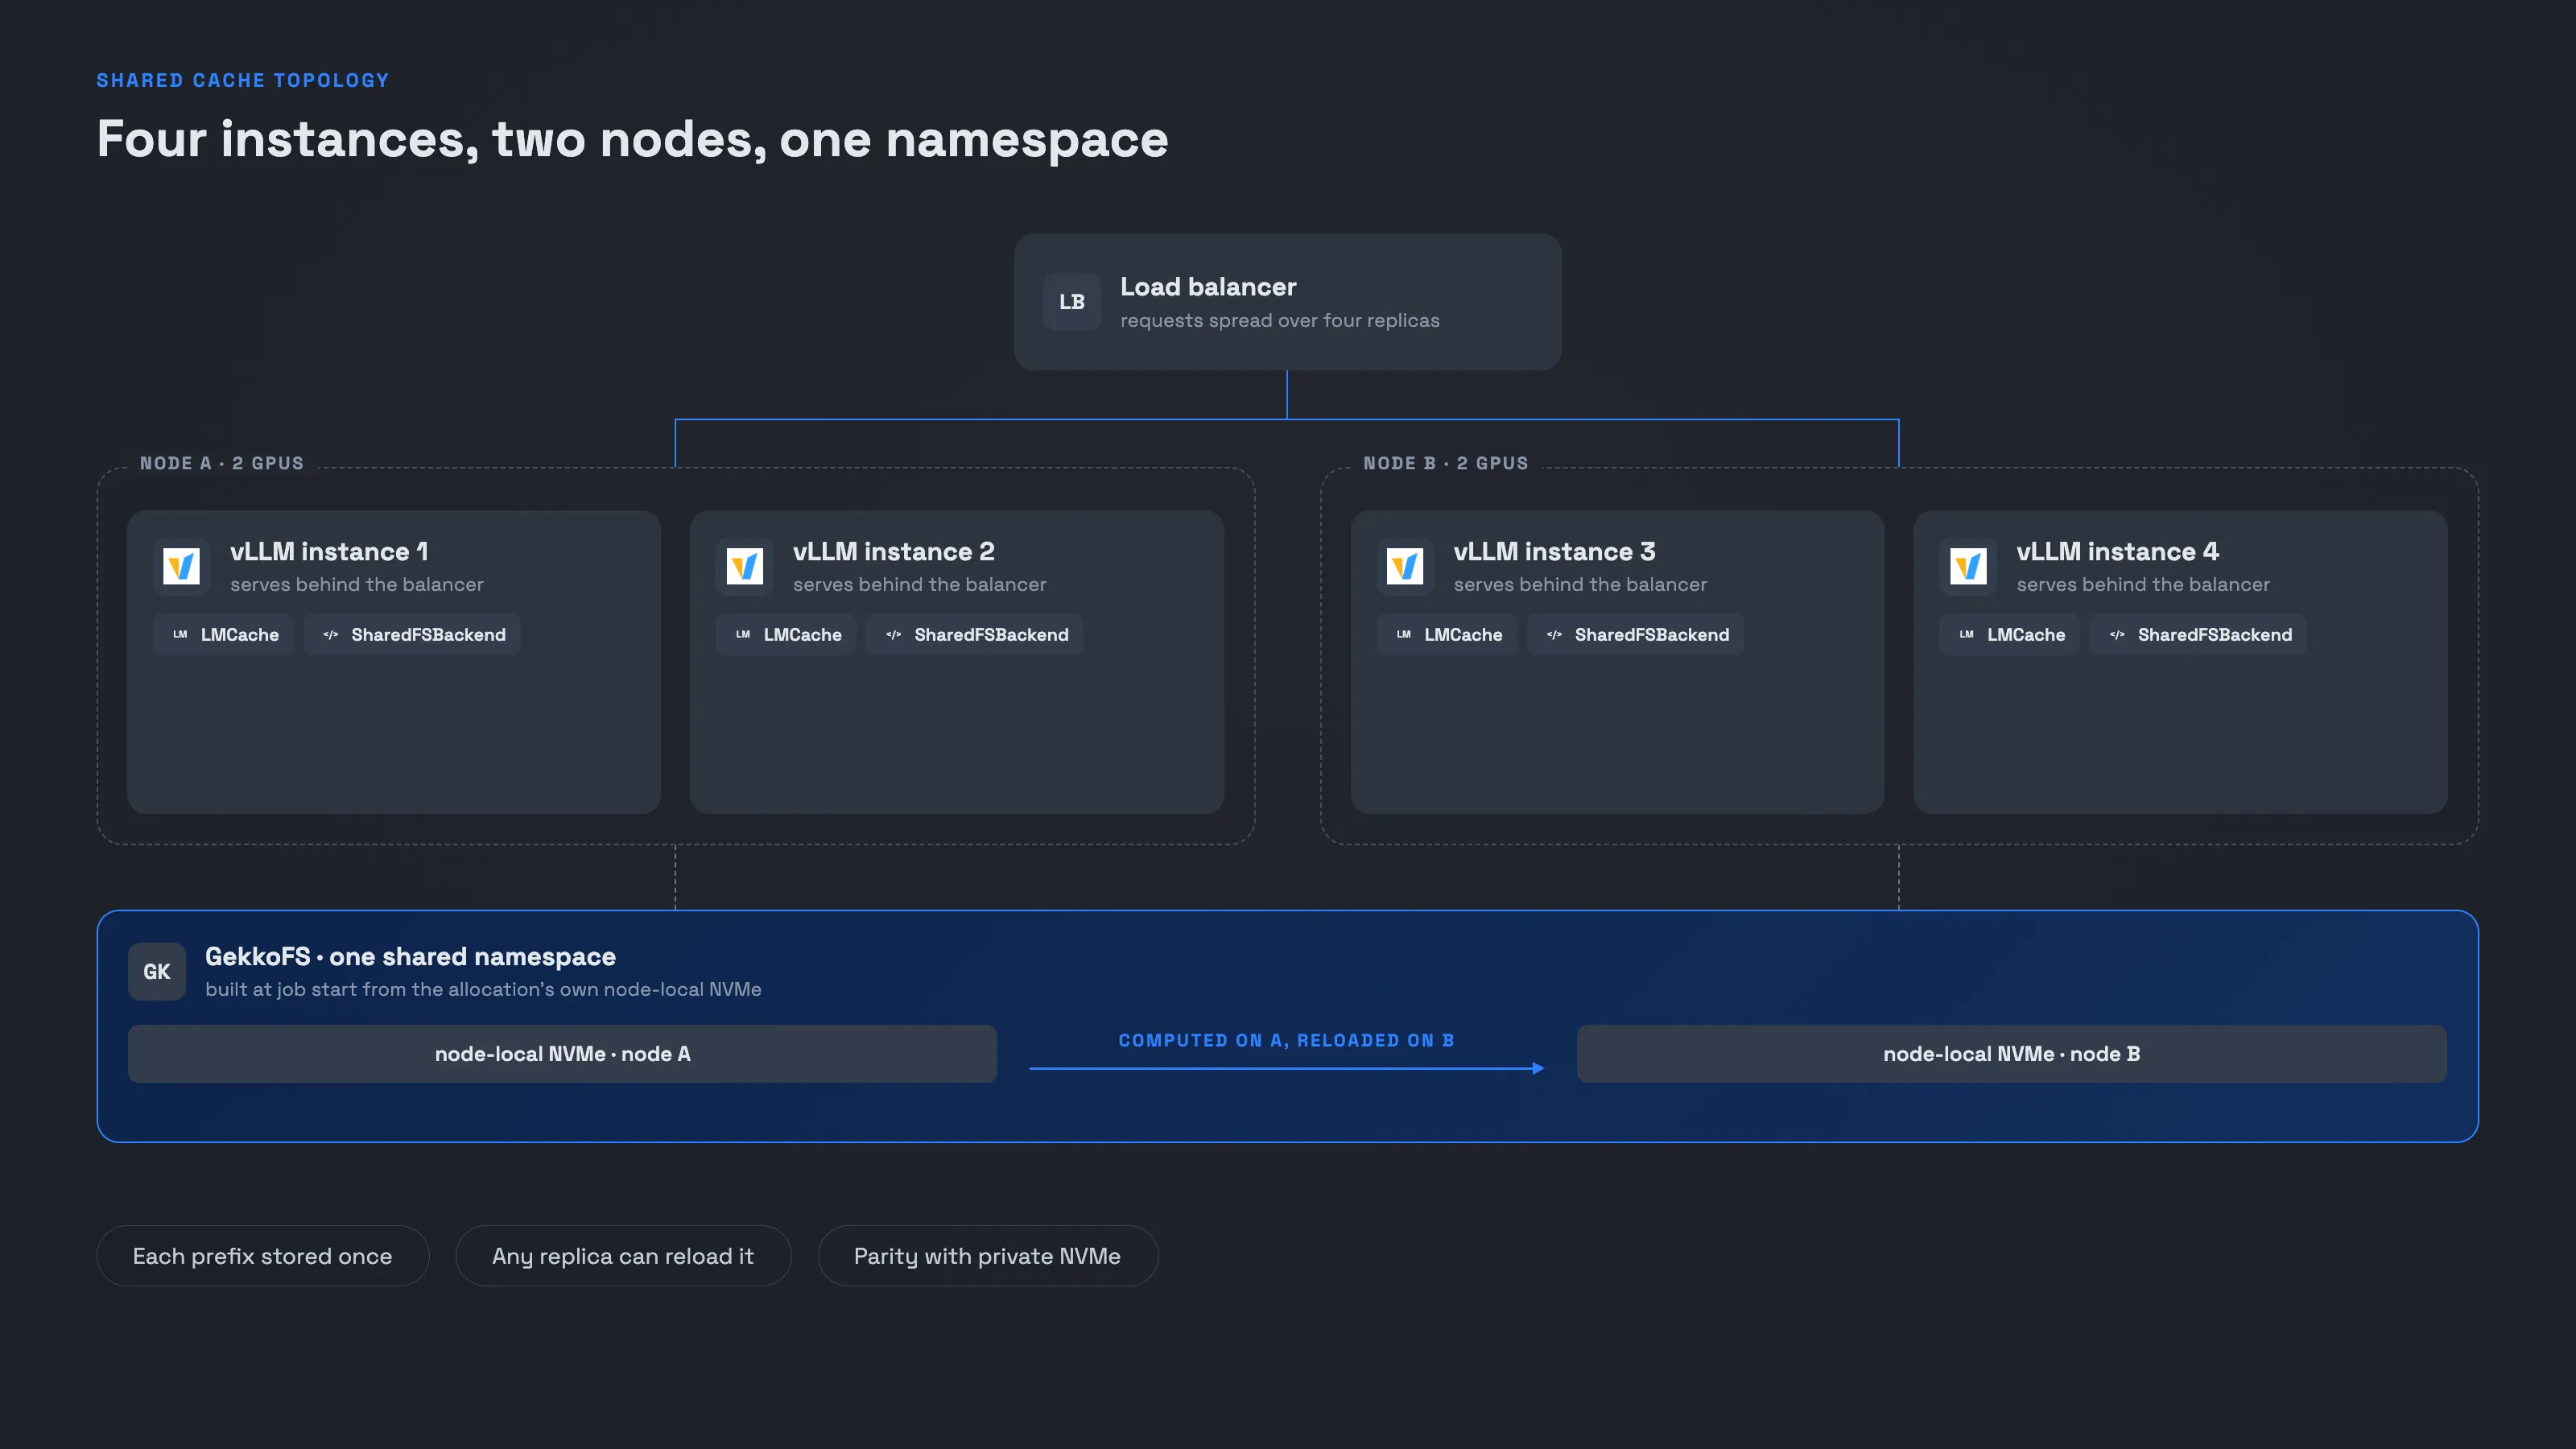
Bei vier vLLM-Instanzen auf zwei Knoten mit einem gemeinsamen GekkoFS-Namespace lädt eine Instanz KV-Daten nach, die eine andere berechnet hat, statt sie neu zu berechnen. Nach dem Tuning liegt der geteilte Tier auf dem Niveau der privaten lokalen Platte.
Backend-Tuning und eine größere Chunk-Size haben das Nachladen eines Dokuments mit 16k Token auf rund 1,9 s gedrückt, und alle Lastfälle liefen durch. Mit der Standardkonfiguration kamen die größten Fälle nicht ans Ziel.
Die Geschichte
Jedes Token, das ein LLM erzeugt, hängt von den Key- und Value-Vektoren aller vorherigen Token ab. vLLM hält sie in einem KV-Cache, um sie nicht neu zu berechnen, und dieser Cache wächst mit Kontextlänge und Parallelität, bis der GPU-Speicher voll ist. Von dort läuft er in den CPU-DRAM über und danach auf NVMe, und ab da entscheidet der Storage-Pfad mit, wie schnell das erste Token zurückkommt. Veröffentlichte Systeme zeigen, dass Offloading funktioniert. Kaum eines sagt, was der Storage darunter leisten muss.
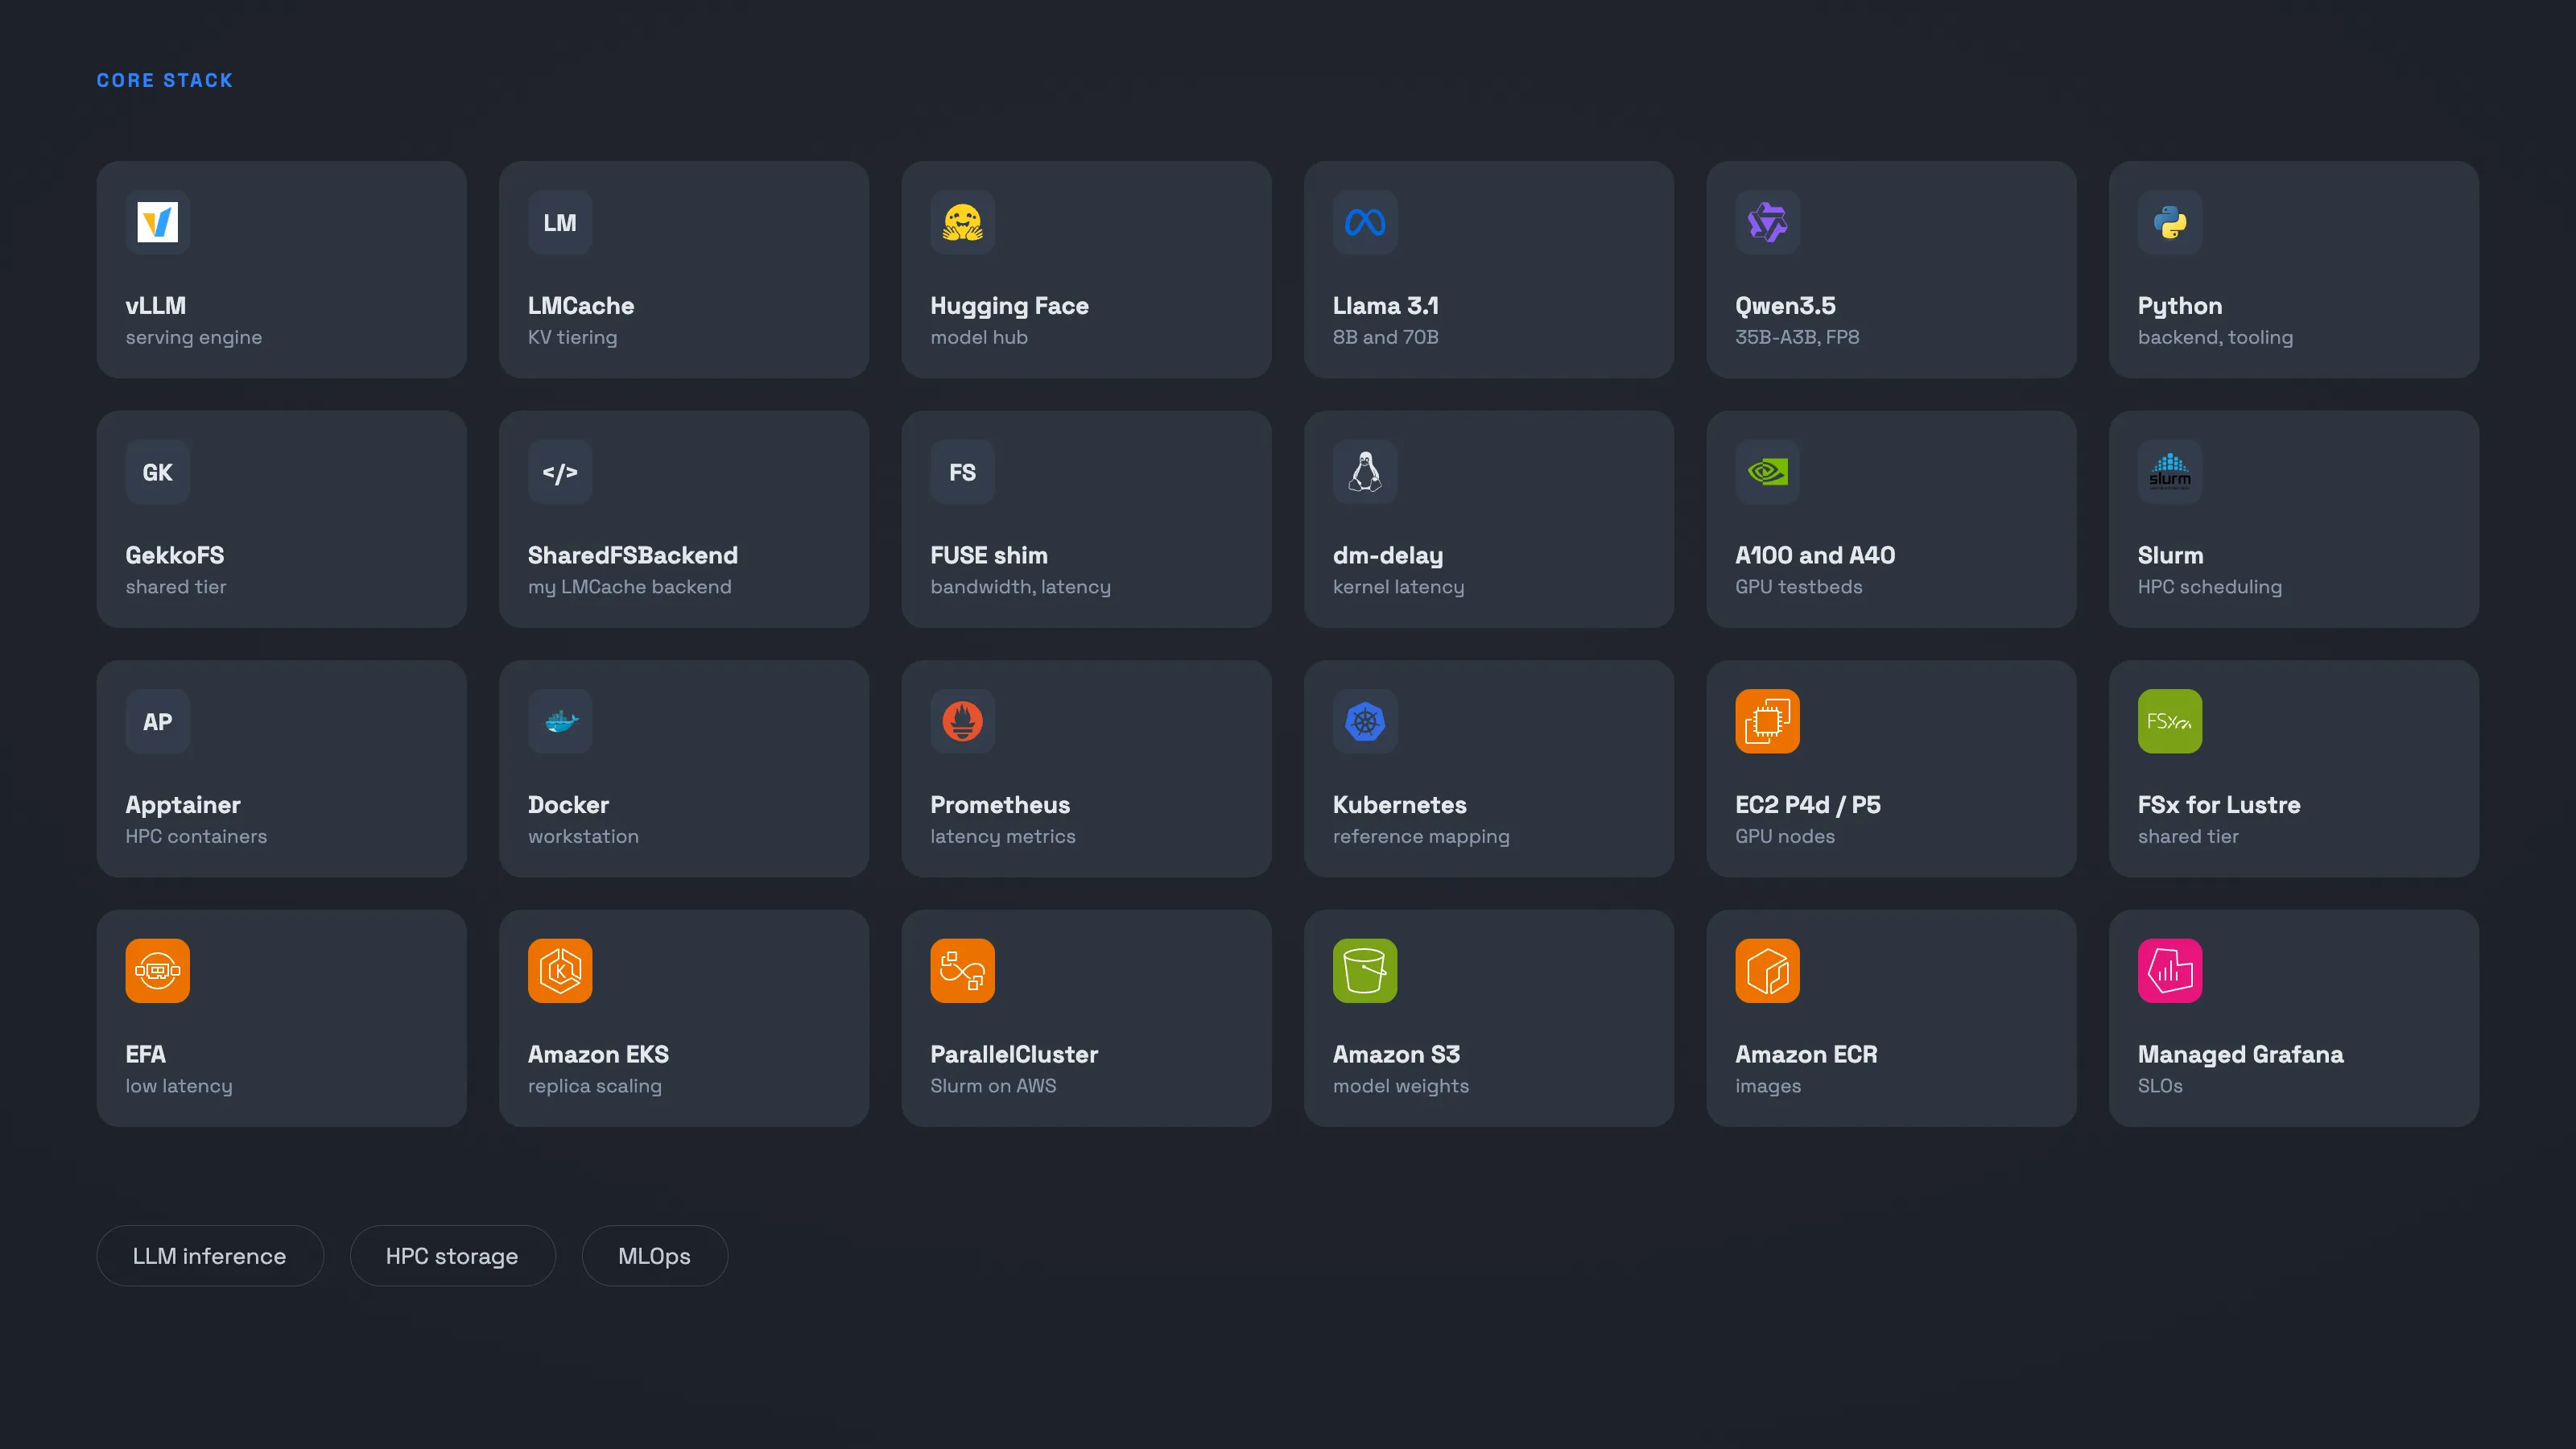
Die Experimentierplattform habe ich auf vLLM 0.19 mit LMCache als Tiering-Schicht aufgebaut, containerisiert mit Apptainer auf dem Mogon-Cluster und Docker auf einer GPU-Workstation, angetrieben von ShareGPT- und BurstGPT-Traffic. Vierzehn Experimente reichen von einer einzelnen GPU bis zu produktionsnahem Traffic auf einem 70B-Modell mit Tensor-Parallelismus. Die Storage-Variable habe ich mit einem FUSE-Throttling-Shim isoliert, der Bandbreite deckelt und Latenz pro Operation unabhängig davon einspeist, und die Reihenfolge gegen ein dm-delay-Device auf Kernel-Ebene gegengeprüft.
Was das bedeutet
Die Ergebnisse verorten die Kosten genau. Das Schreiben des Caches ist im eingeschwungenen Zustand nahezu umsonst, und Decode fasst den Storage nie an, also landet die gesamte Last auf dem Prefill. Innerhalb des Prefill bindet die Latenz pro Operation, die Bandbreite spielt kaum eine Rolle. Das liest sich wie eine Anforderungsliste für jeden Tier unterhalb des Caches: ein Bruchteil der Bandbreite einer einzelnen NVMe genügt, aber jede Millisekunde Round-Trip wird voll bezahlt.
Genau bei vernetztem Storage ist niedrige Latenz schwer zu halten, deshalb habe ich GekkoFS eingebunden, ein Ad-hoc-Dateisystem, das beim Jobstart aus den knotenlokalen NVMes der eigenen Allokation entsteht. Ich habe SharedFSBackend geschrieben, das es als geteilten Disk-Tier an LMCache anbindet. Auf einer einzelnen Instanz verlor es gegen lokale NVMe und las mit rund 0,7 GB/s gegenüber 6 GB/s, ohne etwas, hinter dem sich der Round-Trip verstecken könnte. Sein Wert zeigte sich, sobald mehrere Instanzen hinter einem Load Balancer bedienten. Ein privater Cache bedeutet, dass jede Replik Arbeit neu berechnet, die ihre Nachbarn schon erledigt haben, während ein gemeinsamer Namespace jeden Prefix einmal speichert und jede Replik ihn lesen lässt.
Entwurfsregel
Für eine Inferenzplattform ist die Entwurfsregel konkret. Die heißen Tiers bleiben knotenlokal, und jeder geteilte Tier wird zuerst nach seiner Latenz pro Operation beurteilt, erst danach nach Durchsatz. Ein geteilter Tier verdient seinen Platz, sobald die Flotte mehr als eine Replik betreibt und Nutzer sich Prefixe teilen. Das 8B-Modell, mit dem die meisten Läufe entstanden sind, ist der härteste Fall für einen Gewinn durch Nachladen, die hier gemessene Parity ist also eine Untergrenze. Bei 70B, wo Neuberechnung pro Token deutlich mehr kostet, sollte derselbe Entwurf aus Parity einen Latenzgewinn machen.
Technologie




Andere interessante Case Studies
Steht bei Ihnen etwas Ähnliches an?
Erzählen Sie mir, was Sie heute betreiben und wo es hakt. Ich melde mich mit einem Vorschlag, wie ich es bauen würde und was ich so lassen würde.
Projekt besprechen