AWS-Architektur für eine Live-Produktdaten-Pipeline, vom nächtlichen Batch zu Kafka Streams
Millionen Produkte und eine Datenpipeline, die sie einmal pro Nacht verarbeitet hat, wenn sie nicht fehlschlug.
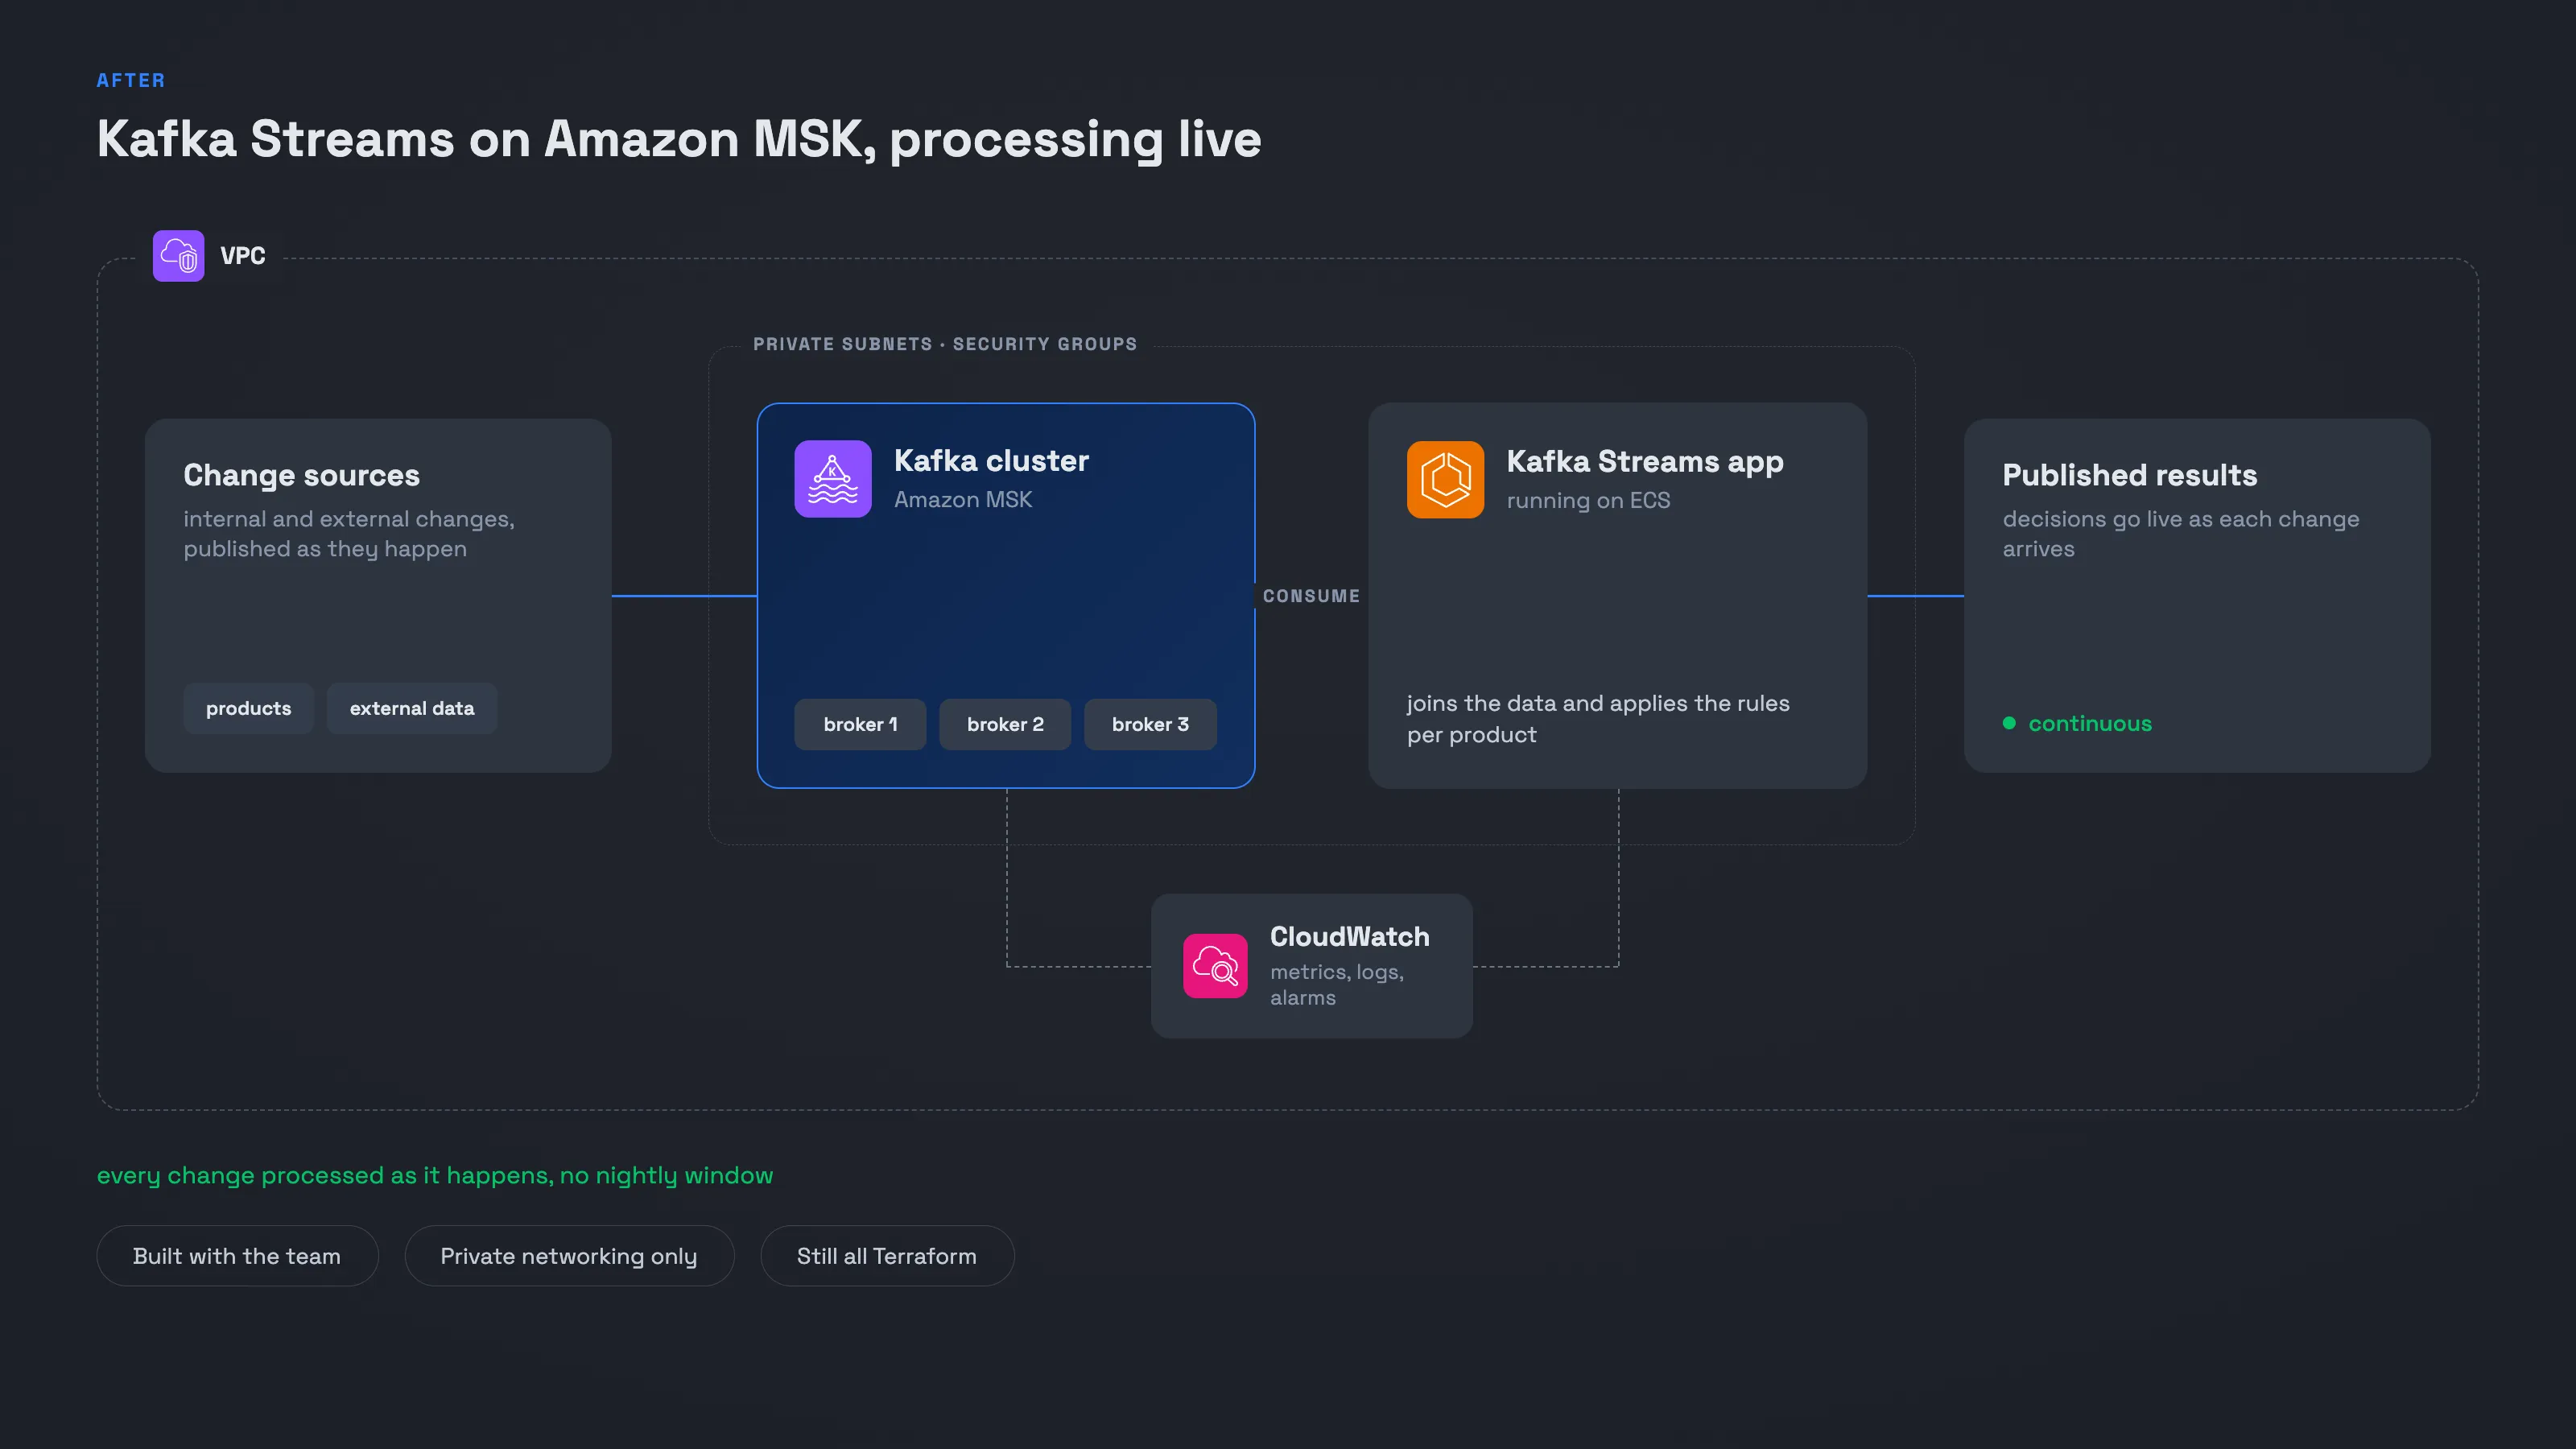
Keine fehlgeschlagenen Nachtläufe und keine manuellen Replays mehr. Die Streaming-Pipeline verarbeitet jede Änderung für sich, in privaten Subnetzen mit eng gefassten Security Groups.
Entscheidungen beruhen auf aktuellen statt auf gestrigen Daten, die Ergebnisse werden besser und erreichen Kunden früher.
Die Geschichte
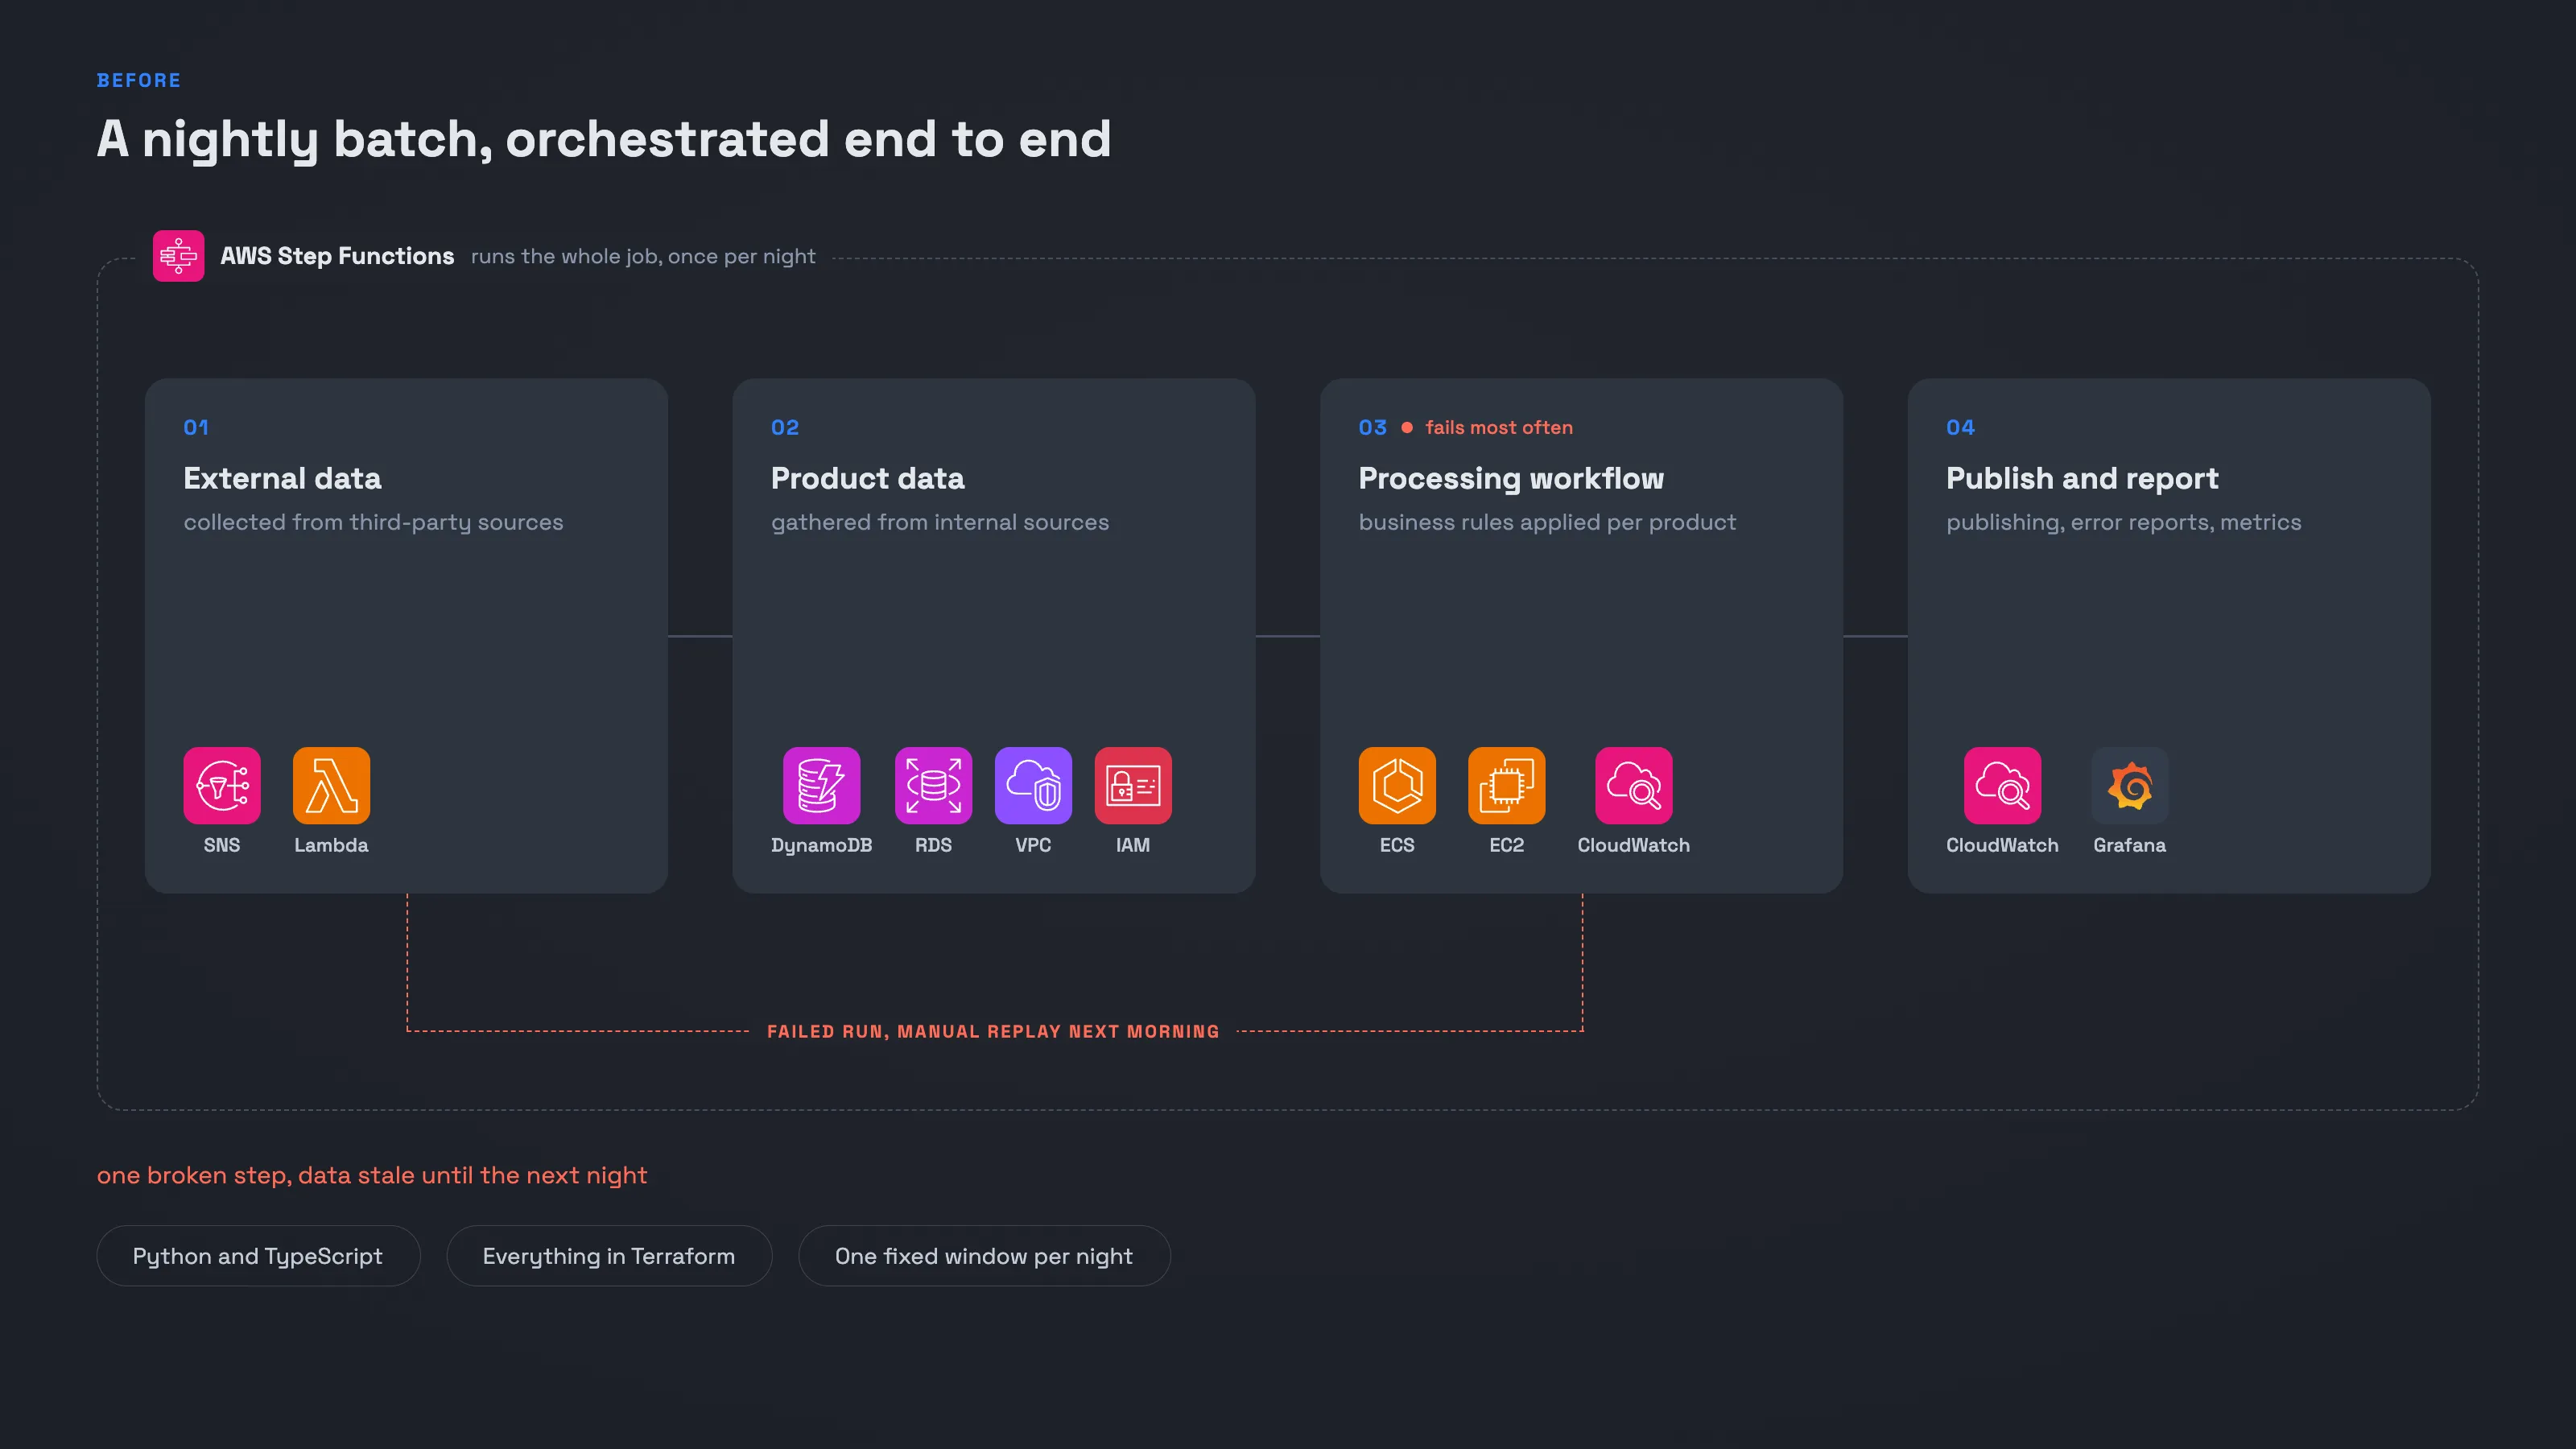
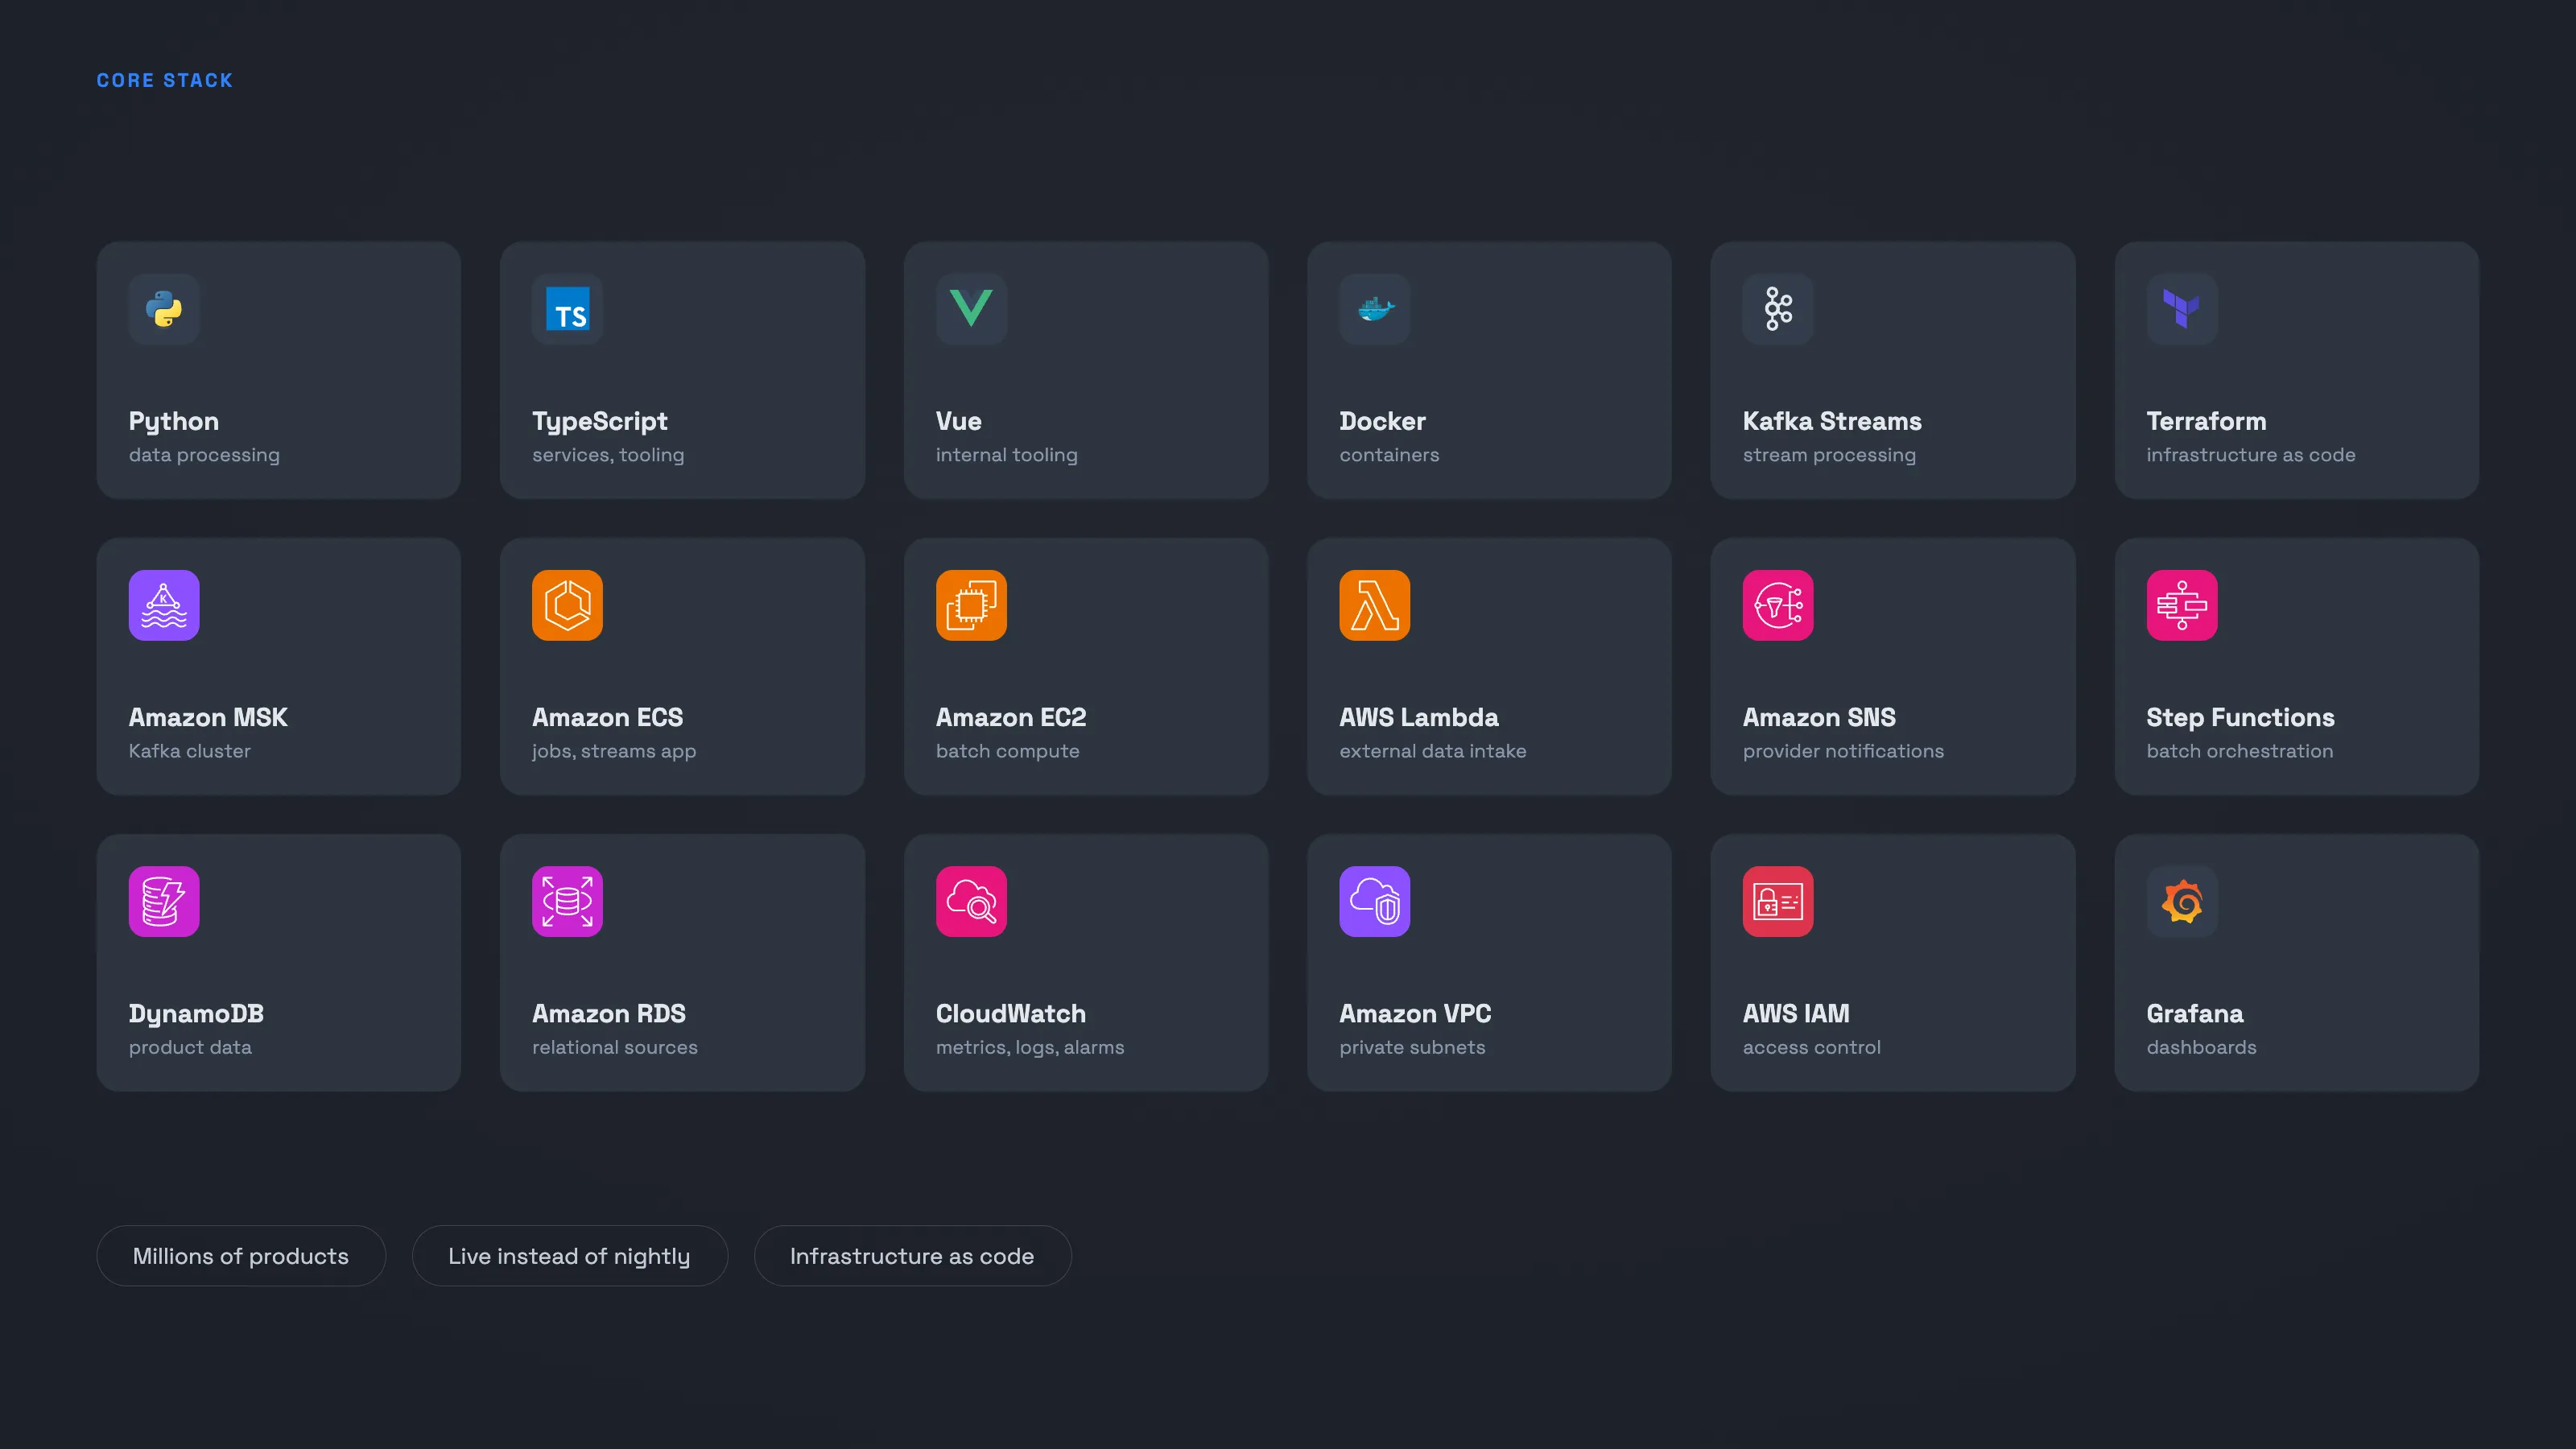
Jedes Produkt im Katalog muss nach Geschäftsregeln verarbeitet und veröffentlicht werden. Bei Millionen Produkten lief das als nächtlicher Batch-Job. Step Functions orchestrierten SNS, Lambdas, ECS-Jobs, EC2 und DynamoDB, geschrieben in Python und TypeScript und mit Terraform bereitgestellt.
Ich habe diese Pipeline betreut, und sie fiel oft aus. Sie war eine lange Kette von Schritten in einem festen Zeitfenster, ein kaputter Schritt ließ die Daten also bis zur nächsten Nacht veralten.
Im Team habe ich sie als Kafka-Streams-Anwendung auf Amazon MSK neu gebaut, betrieben auf ECS in privaten Subnetzen. Änderungen laufen jetzt durch Kafka und werden verarbeitet, sobald sie auftreten, statt einmal pro Nacht.
Technologie


Andere interessante Case Studies
Steht bei Ihnen etwas Ähnliches an?
Erzählen Sie mir, was Sie heute betreiben und wo es hakt. Ich melde mich mit einem Vorschlag, wie ich es bauen würde und was ich so lassen würde.
Projekt besprechen